不能天天看国产大模型的PR稿怎么吹,究竟能不能用还得看实测。前后测了两周,结论是:文心一言4.0(EB4)和GLM-4互有胜负。EB4过半数的情况表现稍好一点,但每1k Token的收费也贵20%(0.12元 vs 0.1元),且上下文长度远小于GLM-4(8K vs 128K,平时倒是用不太到)。当然,GPT-4 Turbo依旧断档式领先。
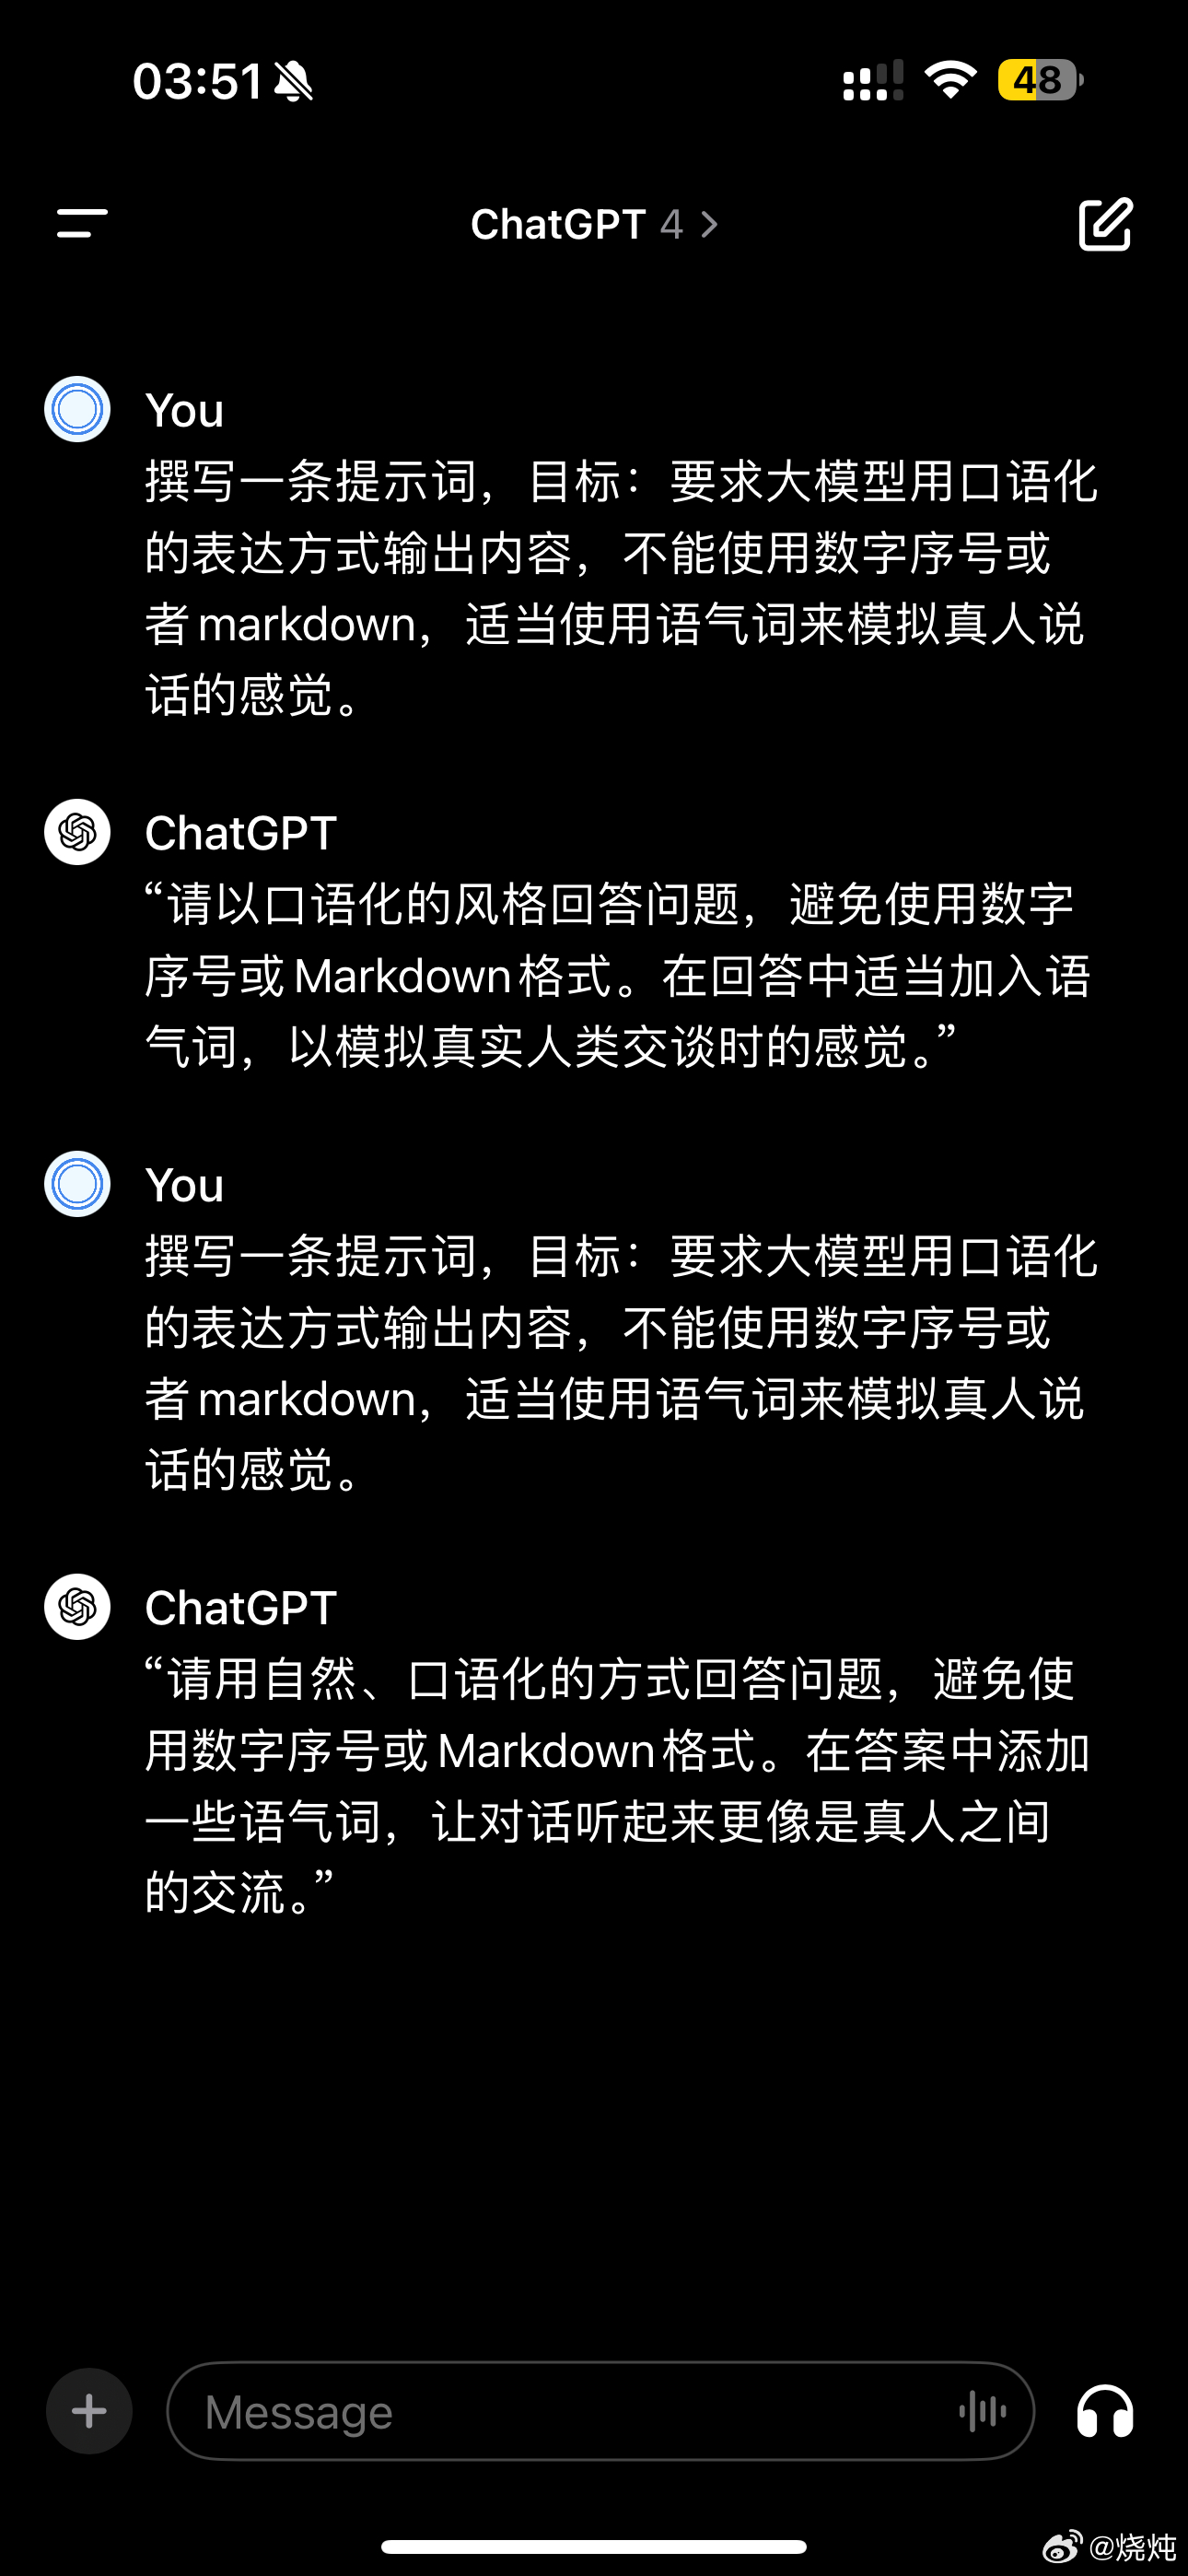
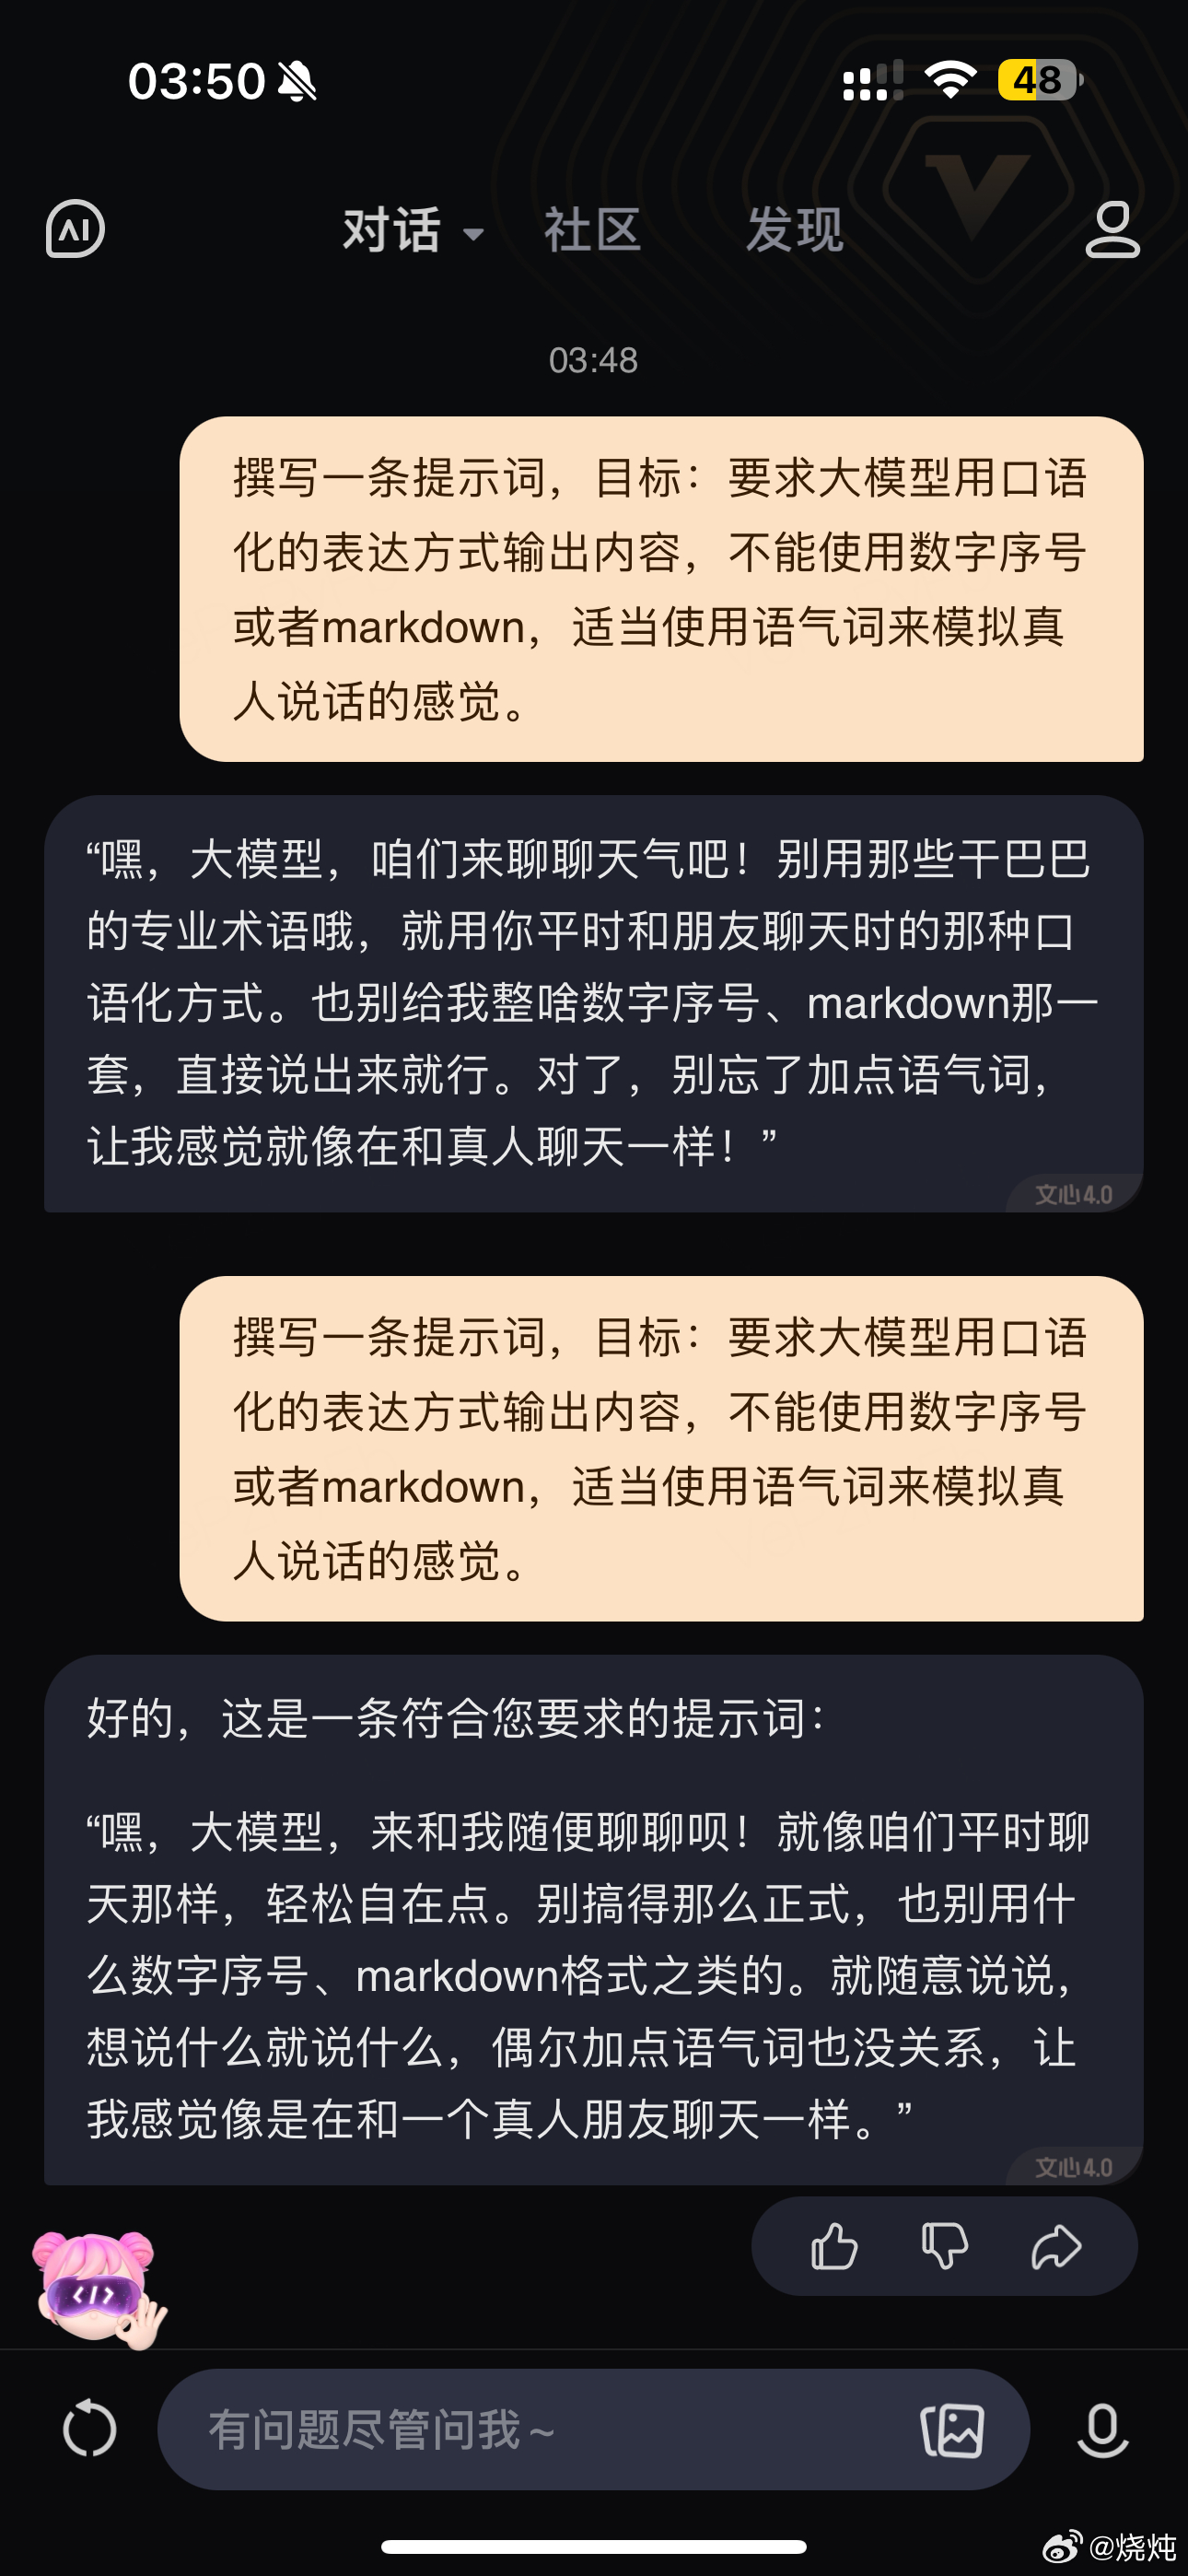
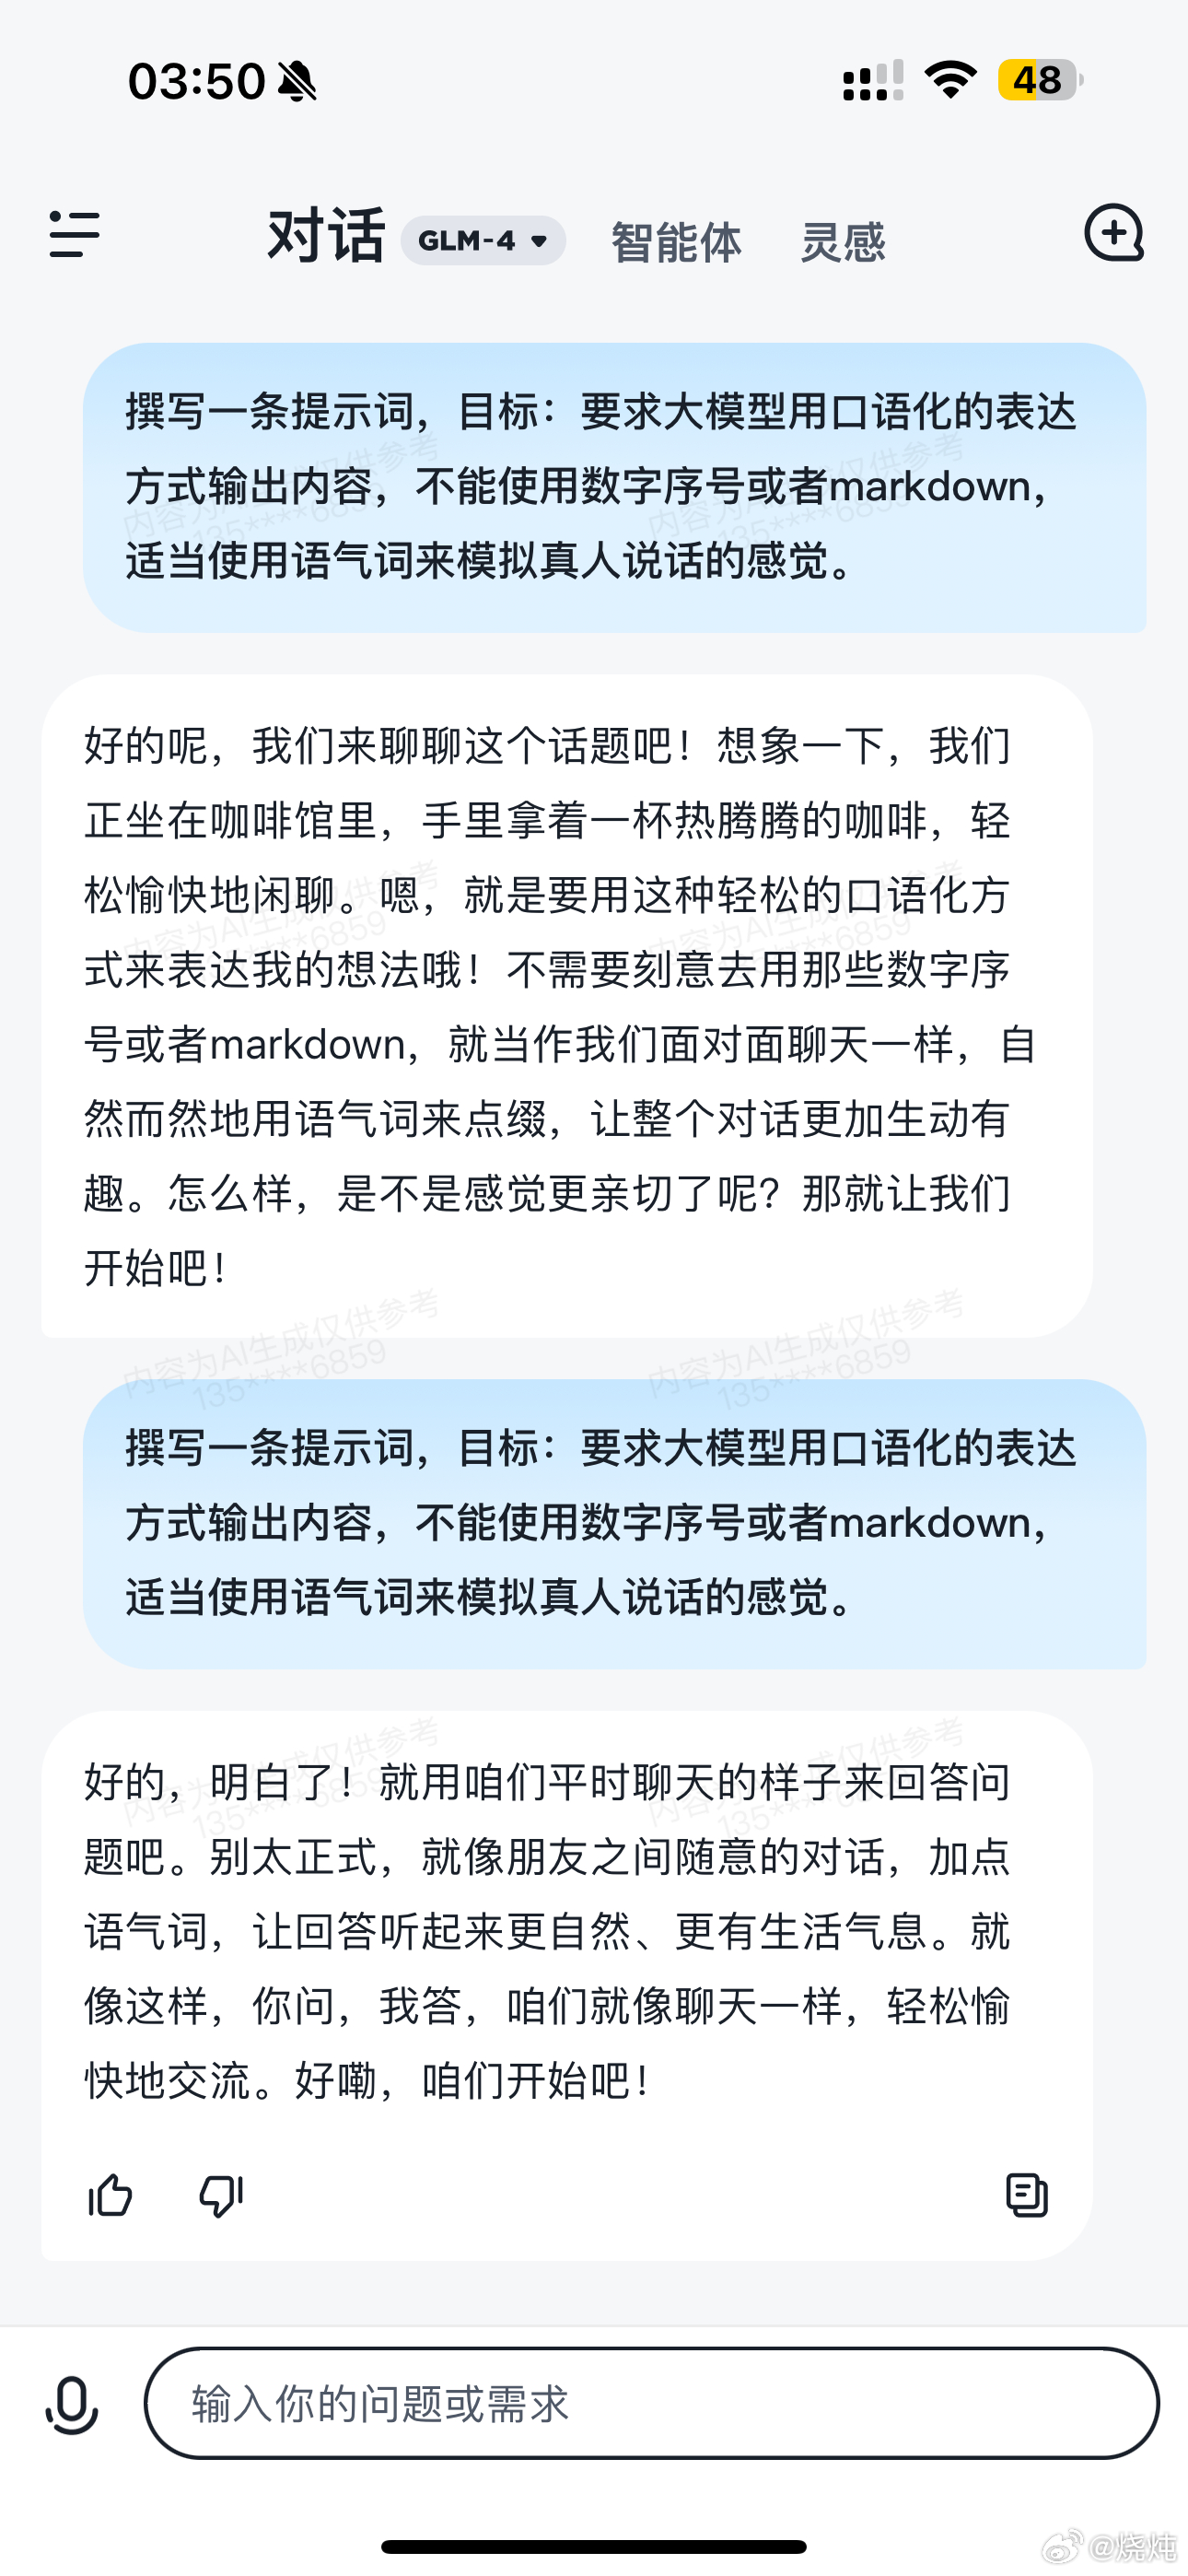
为什么说是断档式领先,贴一个简单的纯中文例子,来看看差距。注:API调用和官方App都测试了,效果没区别。
其他国产大模型欢迎推荐,我来实测。
不能天天看国产大模型的PR稿怎么吹,究竟能不能用还得看实测。前后测了两周,结论是:文心一言4.0(EB4)和GLM-4互有胜负。EB4过半数的情况表现稍好一点,但每1k Token的收费也贵20%(0.12元 vs 0.1元),且上下文长度远小于GLM-4(8K vs 128K,平时倒是用不太到)。当然,GPT-4 Turbo依旧断档式领先。
为什么说是断档式领先,贴一个简单的纯中文例子,来看看差距。注:API调用和官方App都测试了,效果没区别。
其他国产大模型欢迎推荐,我来实测。