懂行的人都在捏把汗!2026年中国大模型八强名单出炉,可谁能想到,这看似风光的八家,其实有一半正在等死?大厂底子厚,硬生生把大模型卷成了免费白菜价。创业公司技术不差,但场景少、烧钱快,这场赢者通吃的游戏,真不是靠情怀能撑下去的。
八强这个数字听起来挺热闹,但真正站稳的,说白了就字节、阿里、腾讯、百度这四家。人家不是因为模型有多牛,是因为就算大模型一分钱不赚,自家业务照样撑着,亏得起、耗得起,这叫什么?这叫用钱堆出来的安全感,普通创业公司根本买不到这张票。
豆包靠字节的流量轰炸硬杀出来,截至2026年6月,豆包月活跃用户规模已达3.82亿,稳居国内AI应用首位。通义千问有阿里云的企业客户托底,过去一年阿里云MaaS平台服务客户数增长六倍。
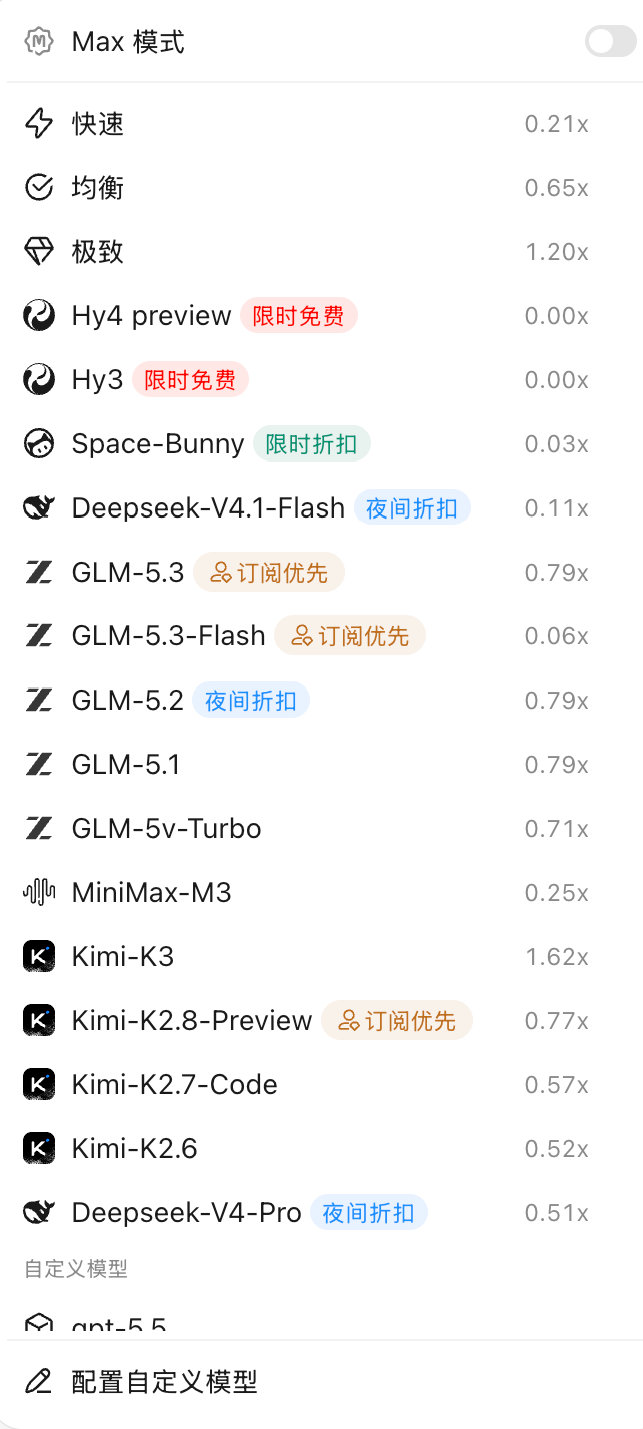
腾讯有微信这头巨象在背后撑着,混元Hy3正式版已接入WorkBuddy、元宝等内部产品。百度搜索入口虽然老了但还没断气,2026年一季度,百度AI业务收入占百度一般性业务收入的比例首次突破52%。这四家打的根本不是大模型的仗,打的是生态战,模型只是他们手里一张新名片而已。
真正让人捏汗的,是另外四家。
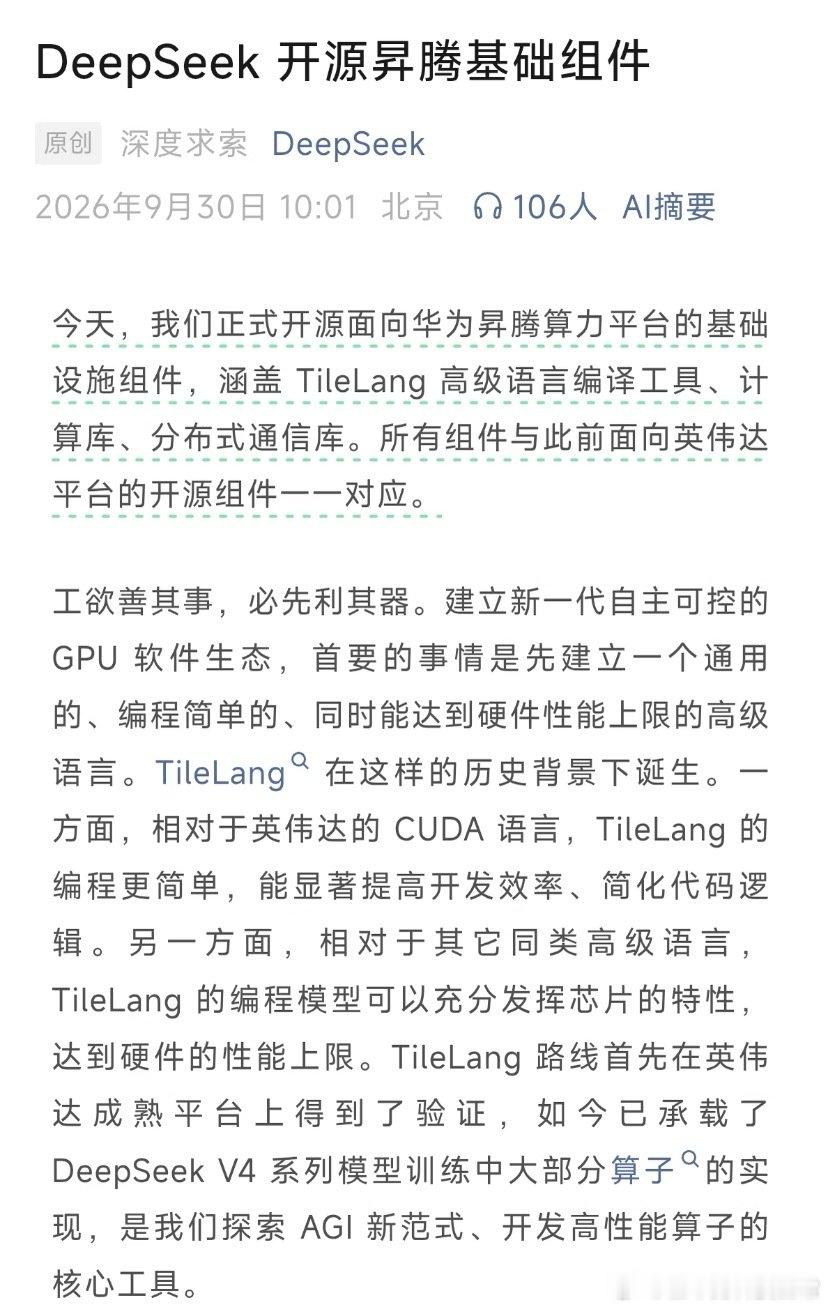
DeepSeek技术圈里名气大,靠极致的成本效率硬是在巨头缝里杀出了存在感,其V4系列处理百万级Token长上下文时,算力消耗仅为上代产品的27%,单位推理成本实现技术性下降。但技术牛归牛,能落地变钱的场景到现在还是短板。不过,DeepSeek已启动大规模融资,2026年10月有消息称其第二轮融资达800亿至近1000亿元人民币,目标估值约5000亿元,腾讯和宁德时代分别考虑投入约100亿元和50亿元。
月之暗面把长文本做到极致,Kimi的年度经常性收入在6月中旬已突破3亿美元,但大厂的追赶速度根本不给你喘气的时间,差异化窗口越来越窄。智谱背靠清华,学术光环够亮,已于2026年1月8日登陆港交所,成为“全球大模型第一股”,2026年上半年实现收入9.54亿元,同比增长399.7%,MaaS收入同比增长2736%,学术基因并没有拖慢其商业化节奏。
MiniMax融资不少,多模态布局也早,已于2026年1月9日在港交所上市,上半年总收入达1.17亿美元,同比增长283.1%,仅半年即达到2025年全年收入的1.5倍,但融资多的另一面是烧钱也快,账上的钱能撑几轮,外人看不透。
有一个行业规律几乎从来没被打破过:用户只会记住最顶尖的那两三个名字,其余的不管技术多扎实,最终都会被遗忘在角落里。大模型这个赛道更残,因为基础能力的差距越来越小,用户根本感知不到第四名和第一名有什么本质区别,那凭什么掏钱选你?
现在最荒唐的局面就在这里,大厂把模型调用价格卷到了白菜价,甚至直接免费开放。过去一年,大模型API调用成本普遍下跌70%到97%,阿里通义直降97%,腾讯混元直接免费,DeepSeek将V4-Pro的API价格永久下调至原定价的四分之一,输入端低至每百万Token 0.025元。这一刀下去,受伤最深的不是大厂自己,是那些还指望靠API收费续命的创业公司。免费这张牌一出,创业公司的商业化逻辑直接被釜底抽薪。
所以接下来这一两年,才是真正的淘汰赛。
要么跑出别人复制不了的差异化场景,把某个垂直领域做到让用户离不开,要么等着被大厂以一个“体面”的价格收购,算是给投资人一个交代,要么就在烧钱里慢慢掉队,最后连被收购的价值都没了。这三条路,没有第四条。
说到底,这场大模型的战争,从来不只是技术的比拼,是弹药储备、场景积累、生态绑定的全面碾压。情怀换不来用户留存,故事撑不住服务器账单。那些还在靠“我们技术不输任何人”来提振士气的团队,现在最该问自己的只有一句话:钱还能烧多久?