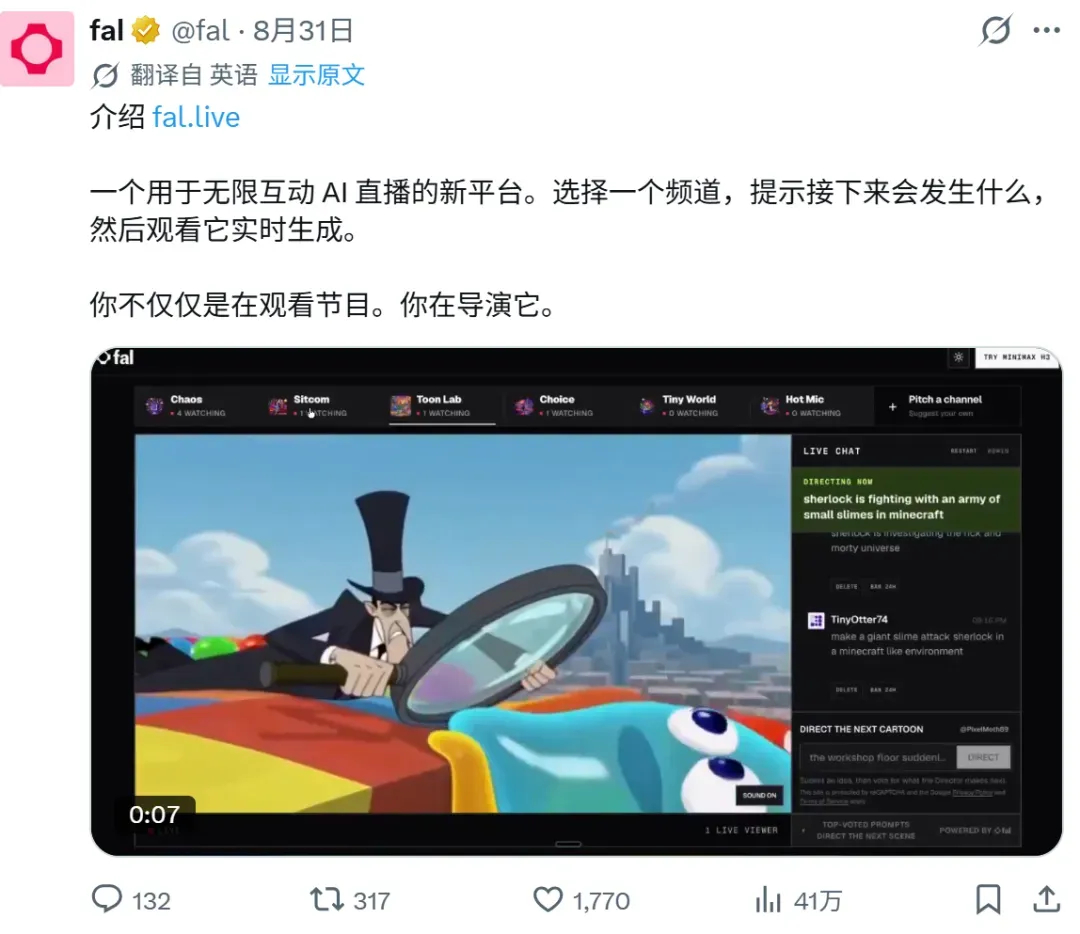
前段时间,fal.live 做的无限AI直播,在海外火过一波。
里面的视频没有固定结局,观众可以一边看一边提交提示词,决定接下来会发生什么。当时很多人第一次直观地看到,AI视频真的可以像直播一样边播边生成了。
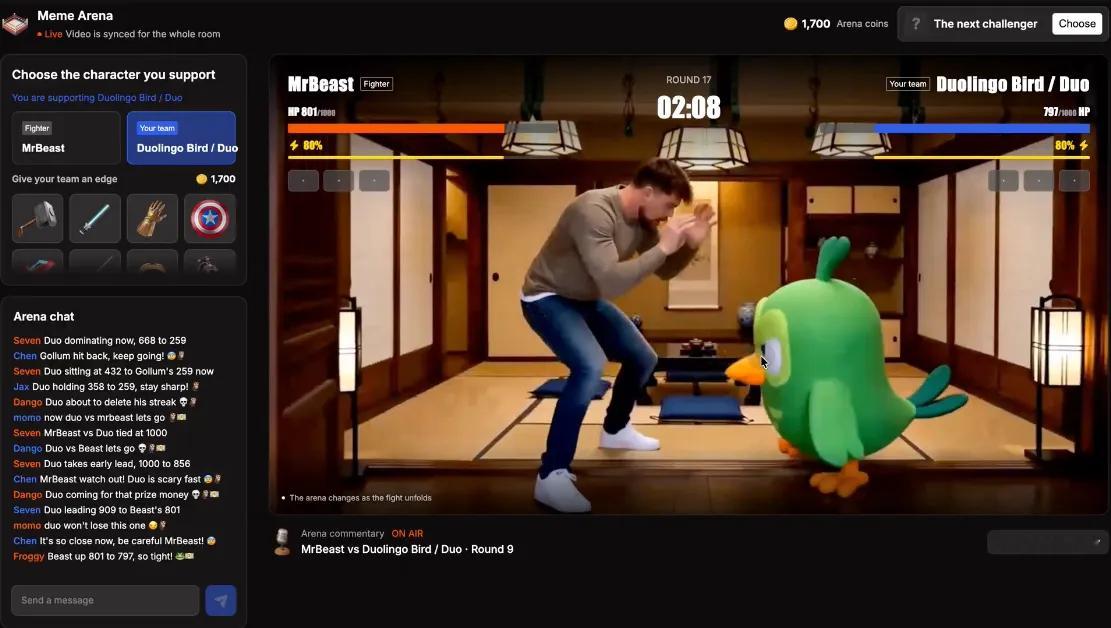
最近,我又看到了一个更互联网原生玩法的版本,叫 Meme Arena!
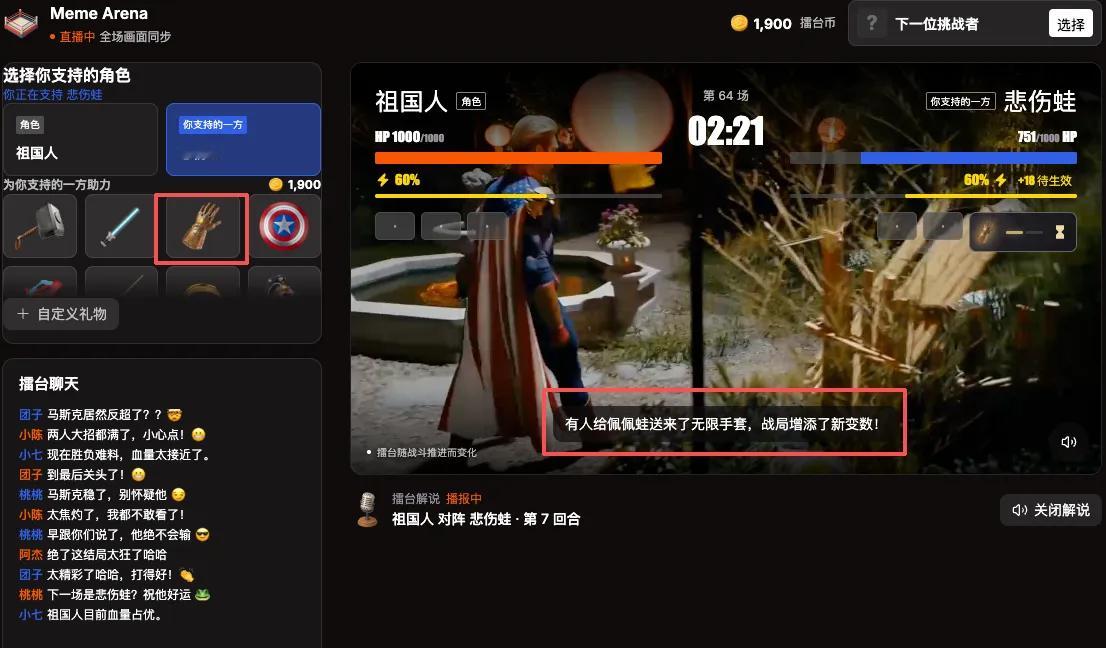
在这个直播间里,你甚至能看到 MrBeast 和多邻国那只绿色猫头鹰对打。观众也不只是围观,你可以上传一张角色图片,再补充一段描述,把一个表情包直接送上擂台🤣
我一开始以为,这就是一个让表情包打起来的AI视频小游戏。但进直播间看了一会儿,我发现它和过去的AI视频产品很不一样。除了角色,你还可以自己上传武器形象,再给它写一段剧情。
比如,我给其中一个角色上传了一只无限手套,补充了它要怎么使用这件武器。无限手套很快就出现在战斗里,并直接影响了接下来的剧情。
这意味着,视频并没有在播放前被完全确定,观众后续加入的内容,也可以成为正在发生的故事的一部分。
我查了一下,Meme Arena 背后的模型叫 Vivix-W1。
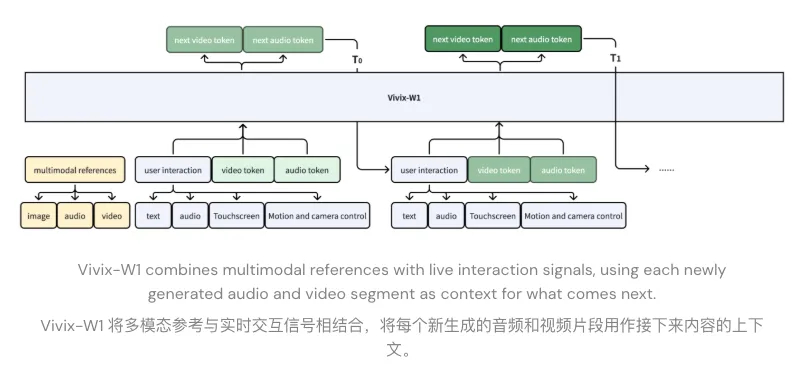
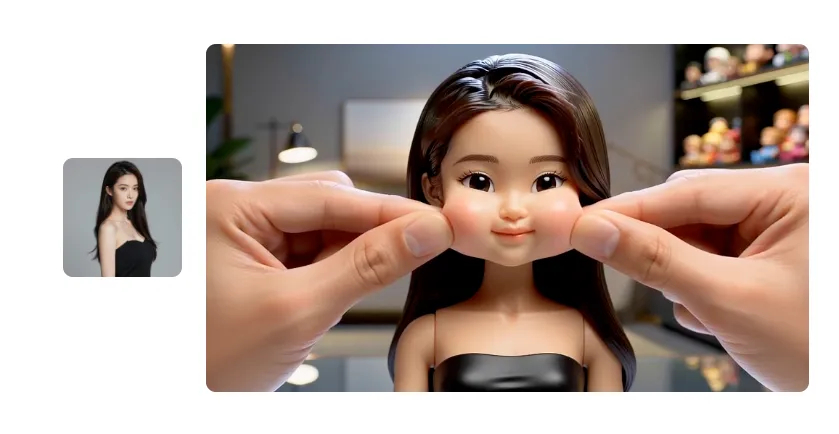
官方把它定义为流式原生多模态模型。简单来说,文字、图片、声音和视频都能成为参考信息,新的交互信号还能在生成开始后继续进入,影响后续的画面和声音。
比如在 Meme Arena 里,观众的操作随时可能进入。模型不会等到整场战斗结束后,再把结果一次性生成出来,而是让视频先开始,同时给后续变化留下入口。
当然,要做到这一点,单纯提高生成速度还不够。普通视频模型可以花几十秒计算一段内容,但实时互动不能让观众一直等,否则一个操作传进去,画面过了很久才发生变化,体验就断了。
Vivix-W1 的处理方式,是把内容拆成连续生成的音视频片段。前面生成的内容会成为后面的上下文,观众在中途加入的图片或指令,也能进入这个过程,继续改变故事的发展。
声音和画面同样由模型共同生成。角色行动时,镜头、对话和环境音会跟着剧情向前推进,而不是等画面完成后再单独拼接。
Vivix 的技术报告里也提到,视频交互每秒处理的信息量比文本交互高出数千倍。为了承担这种压力,W1 会持续生成细粒度的音视频片段,让新输入直接影响后续内容。
当然,模型能生成只是第一步。它还面临一个很现实的问题,就是成本。截至2026年10月12日,Vivix 官方页面给出的活动价格是每个输出秒0.003美元。按8秒视频计算,一次生成约0.024美元,1美元大约可以生成41.7条。
这件事对实时内容尤其重要。因为互动会随着在线时间持续消耗算力,如果每多播放一秒都要承担很高的成本,那么实时生成很难从demo变成真正的产品。
那么,Vivix-W1已经打破画质、速度和成本的不可能三角了吗?现在下结论还有点早。
Vivix 在技术报告中也承认,面对专业级画质、复杂运动和高密度场景时,W1与顶级离线视频模型之间仍然存在差距。更准确地说,它正在改变实时视频的及格线。
影视制作可以等待更长时间,换取更高的画面质量。但互动内容必须先保证观众的操作能够得到及时反馈,只要画面达到可接受的水平,速度和成本反而会决定产品能否成立。
AI视频行业正在出现一条新的分支。原来的路线会继续追求更高的画质,服务广告、影视和专业创作;实时生成则在探索另一种可能,让内容根据观众的参与持续变化。
两条路线并不冲突。如果说 fal.live 证明了AI视频可以持续生成,那么 Meme Arena 展示的,是普通观众可以怎样真正进入内容。
它更像一个足够直观的信号,让我们看见当生成成本降下来之后,视频和观众之间的关系会发生什么变化。
未来很多内容可能不必先被做完,才开始播放。它可以在观众参与的过程中,逐渐长出自己的下一秒。