微软发Maia 300:推理自己扛
当地时间 10 月 12 日,微软在圣何塞的 OCP 全球峰会上发布第三代自研 AI 加速器 Azure Maia 300。
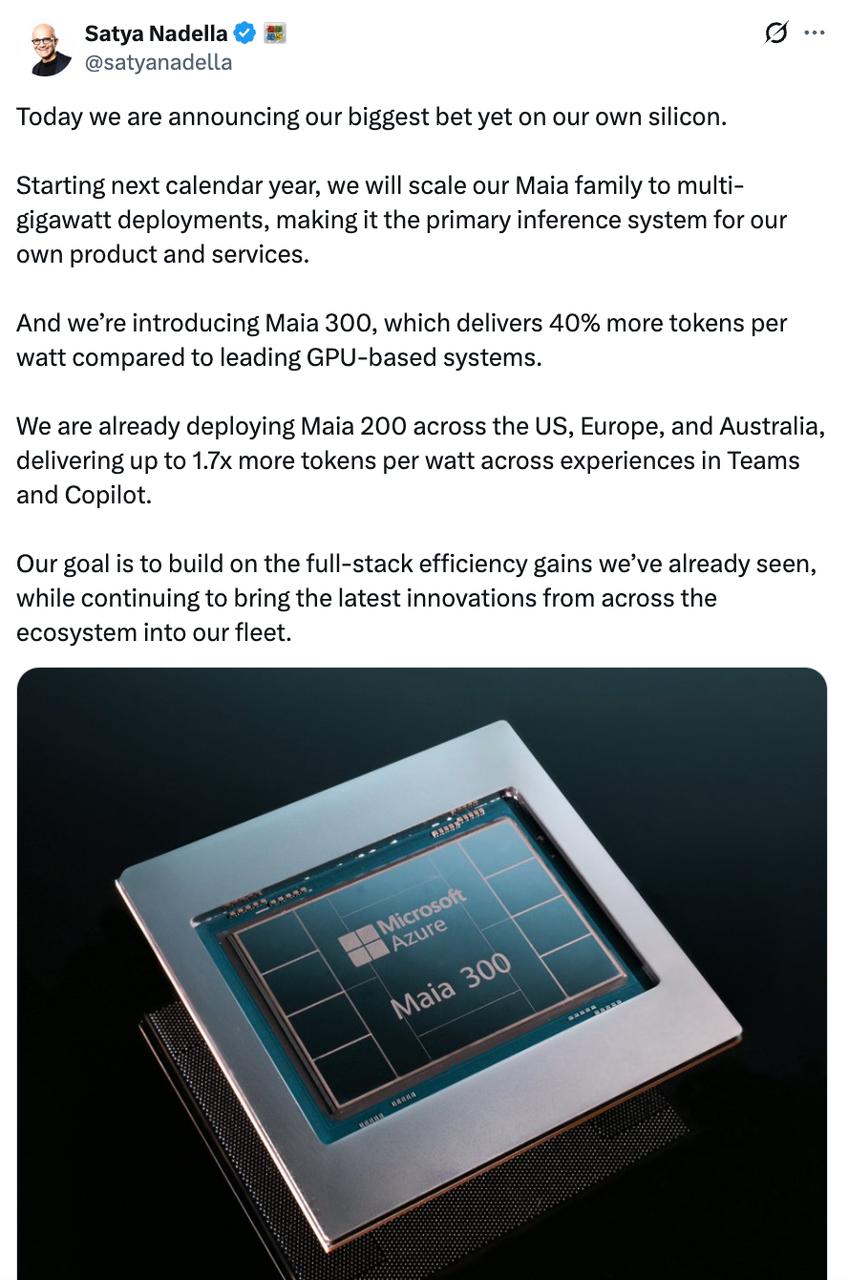
云与 AI 执行副总裁 Scott Guthrie 在博文里给出时间表:2027 年起把 Maia 家族扩到多吉瓦级部署,成为自家产品和服务的主要推理系统;Maia 300 的生产部署也在 2027 年。纳德拉称这是"迄今对自家芯片最大的一次押注"。
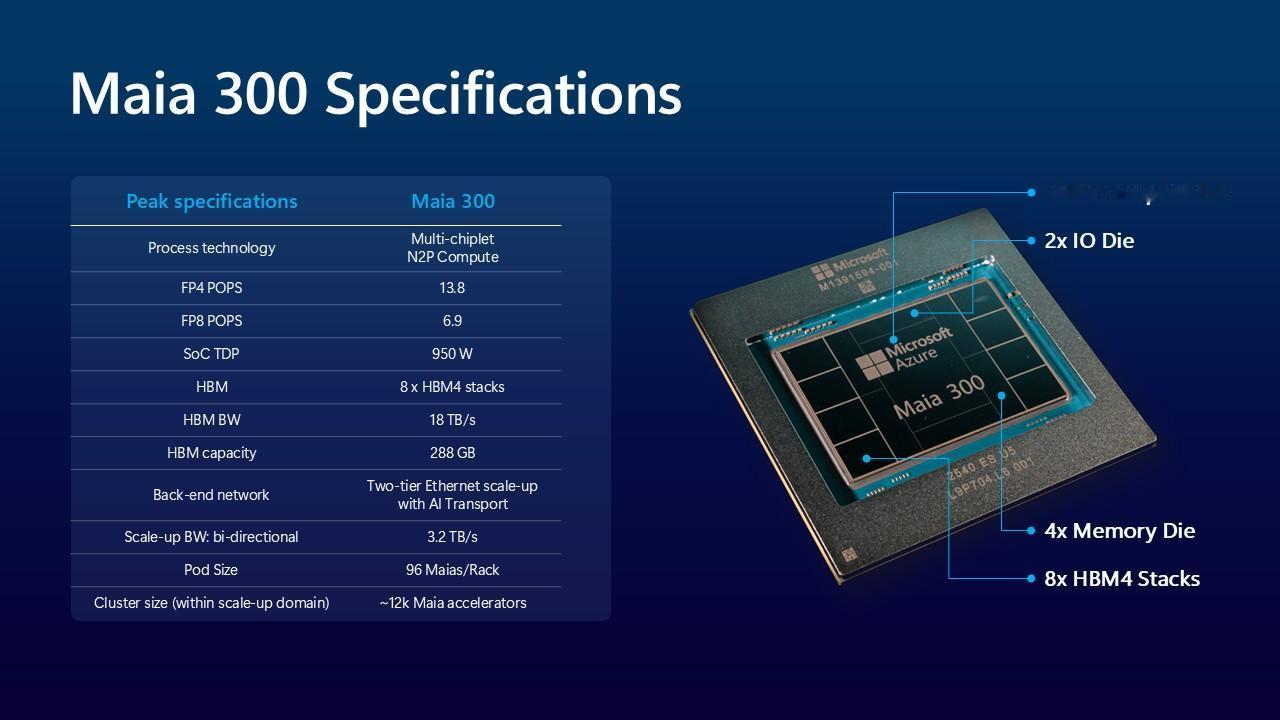
微软给的两个数字是,Maia 300 每兆瓦能处理的 token 比领先的 GPU 系统多 40%,96 颗满配机架的 token 吞吐最高是 Maia 200 的 7 倍;配套论文另称每瓦性能提升超过 2.5 倍。
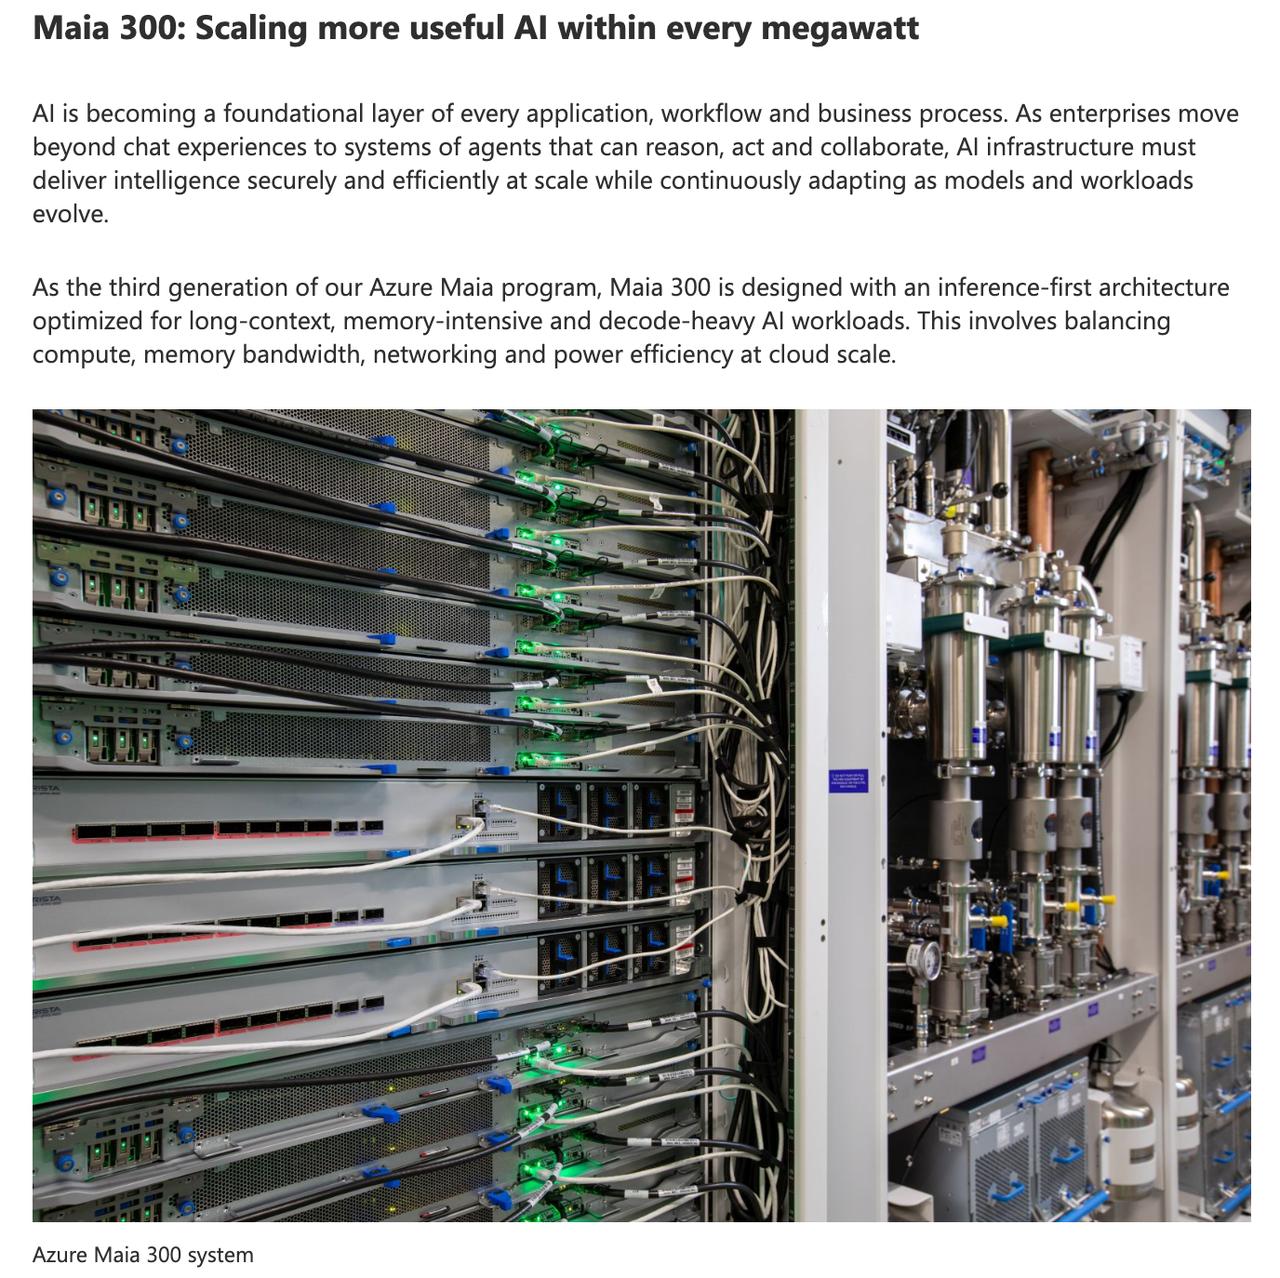
芯片采用多芯粒设计,计算芯粒用台积电 N2P 工艺,8 组 HBM4 提供 288GB 容量和 18TB/s 带宽,整颗 950 瓦;单机架 96 颗、167 千瓦,散热靠液冷。
数字的成色值得留意。40% 和 1.7 倍都出自微软自己的测试,官方只说对标"领先的 GPU 系统",没点名是哪家哪款,也没交代测试模型和上下文长度;40% 用的还是"预期",因为 Maia 300 要到 2027 年才部署。
真正已交付的是上一代:Maia 200 正在美国、欧洲和澳大利亚部署,在 Teams、Copilot 和 Cowork 上每瓦 token 产出最高是领先 GPU 的 1.7 倍。
范围也有限定。"主要推理系统"只指推理,不含训练,微软与英伟达、AMD 在训练上仍是合作,高管拒绝给出多吉瓦部署的时间表。
Maia 200 眼下跑 OpenAI 模型、微软自家 MAI 模型和主流开源模型,GitHub Copilot 与 Foundry 年底前接入。
纳德拉把目标说成"每一瓦、每一美元产出更多有用 token"。
"主要推理系统"是个很重的说法,能否兑现要看 2027 年真正通电的机架上装了多少颗 Maia。