世界模型Odyssey-3开放预览
10 月 8 日,加州公司 Odyssey 的两位创始人发博文《Meet Odyssey-3》,宣布研究预览"现已可用"。
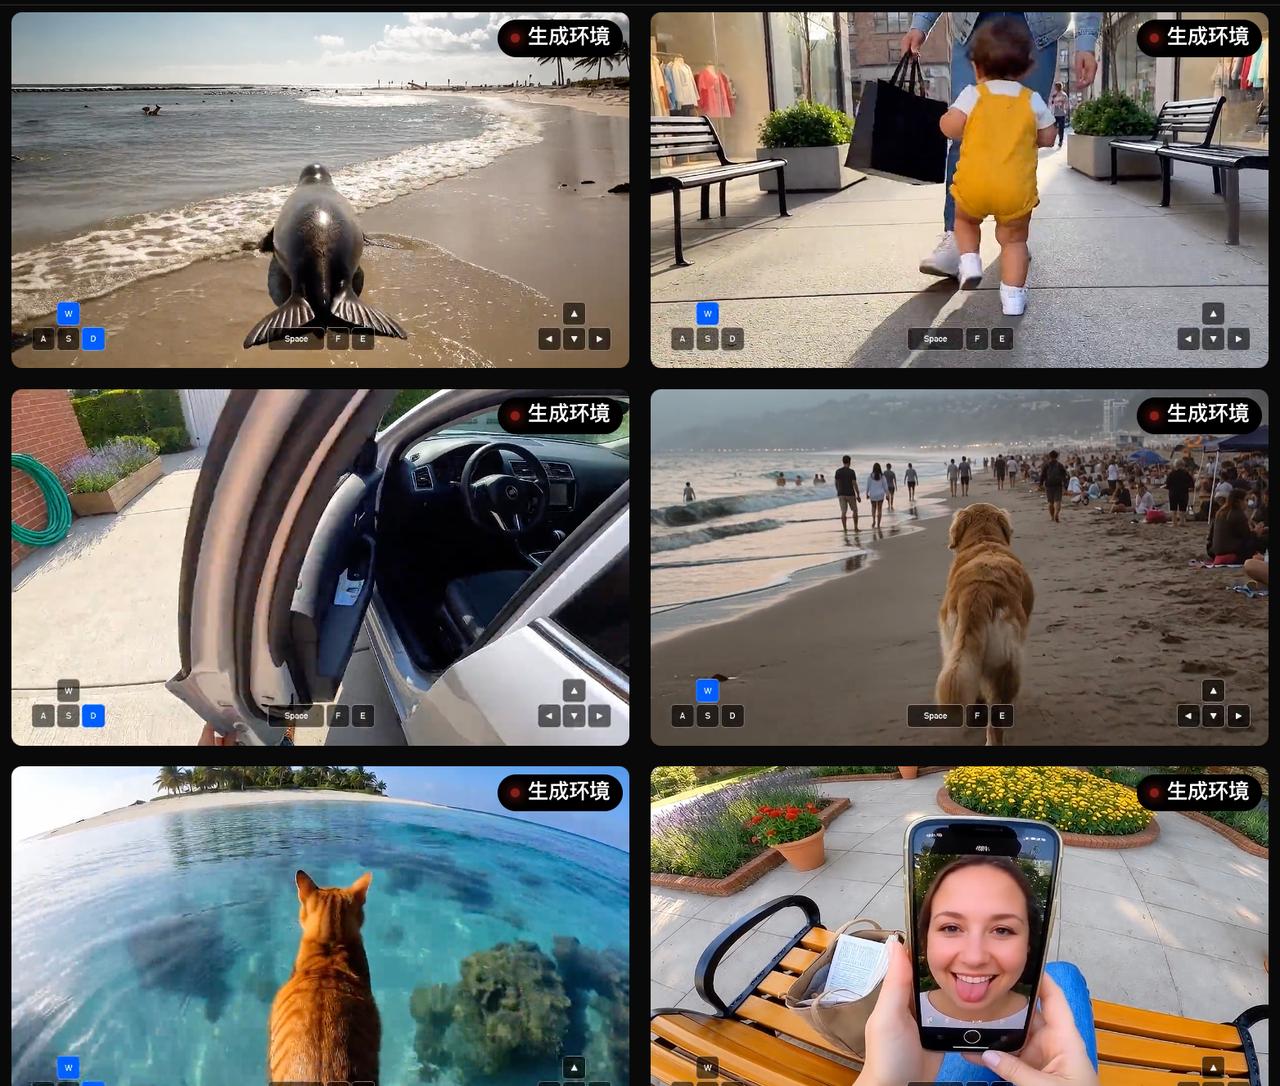
输入一段文本生成具身环境,第一人称或第三人称走进去,随时触发事件,模型按你的动作实时接着生成。浏览器里跑的是蒸馏过的 Flash 版。
官方把 Odyssey-3 定义成"学出来的动力学系统":一个自回归扩散 Transformer,从观测和动作预测世界接下来怎么变。
训练数据里最讲究的一味是游戏录像,官方原话是"带时间对齐键鼠输入的游戏录制"。要按用户动作预测下一帧,就得有"动作和画面成对"的材料,而互联网视频只能配事件描述。
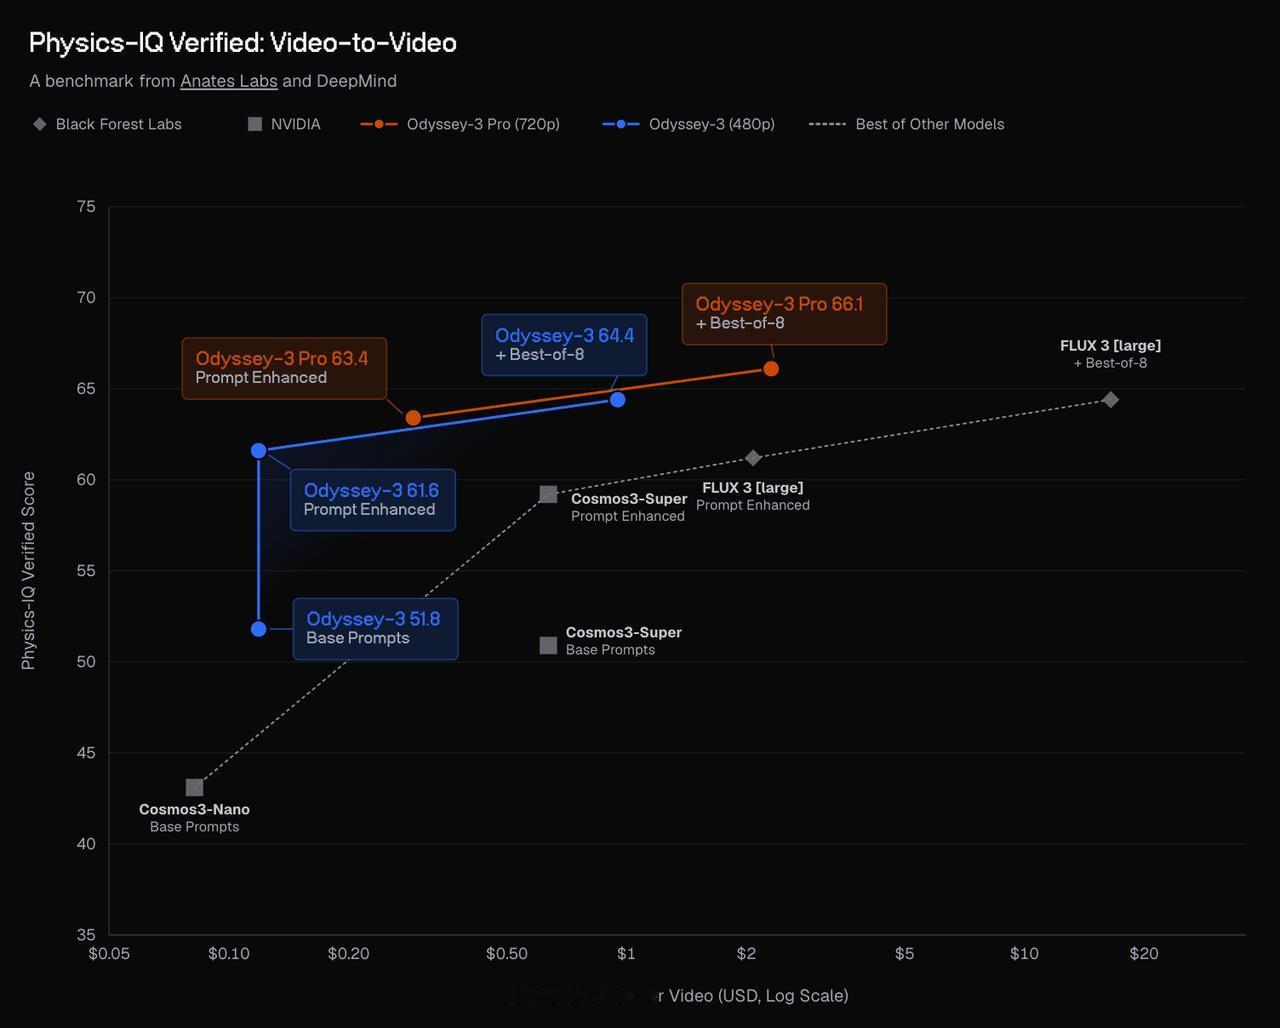
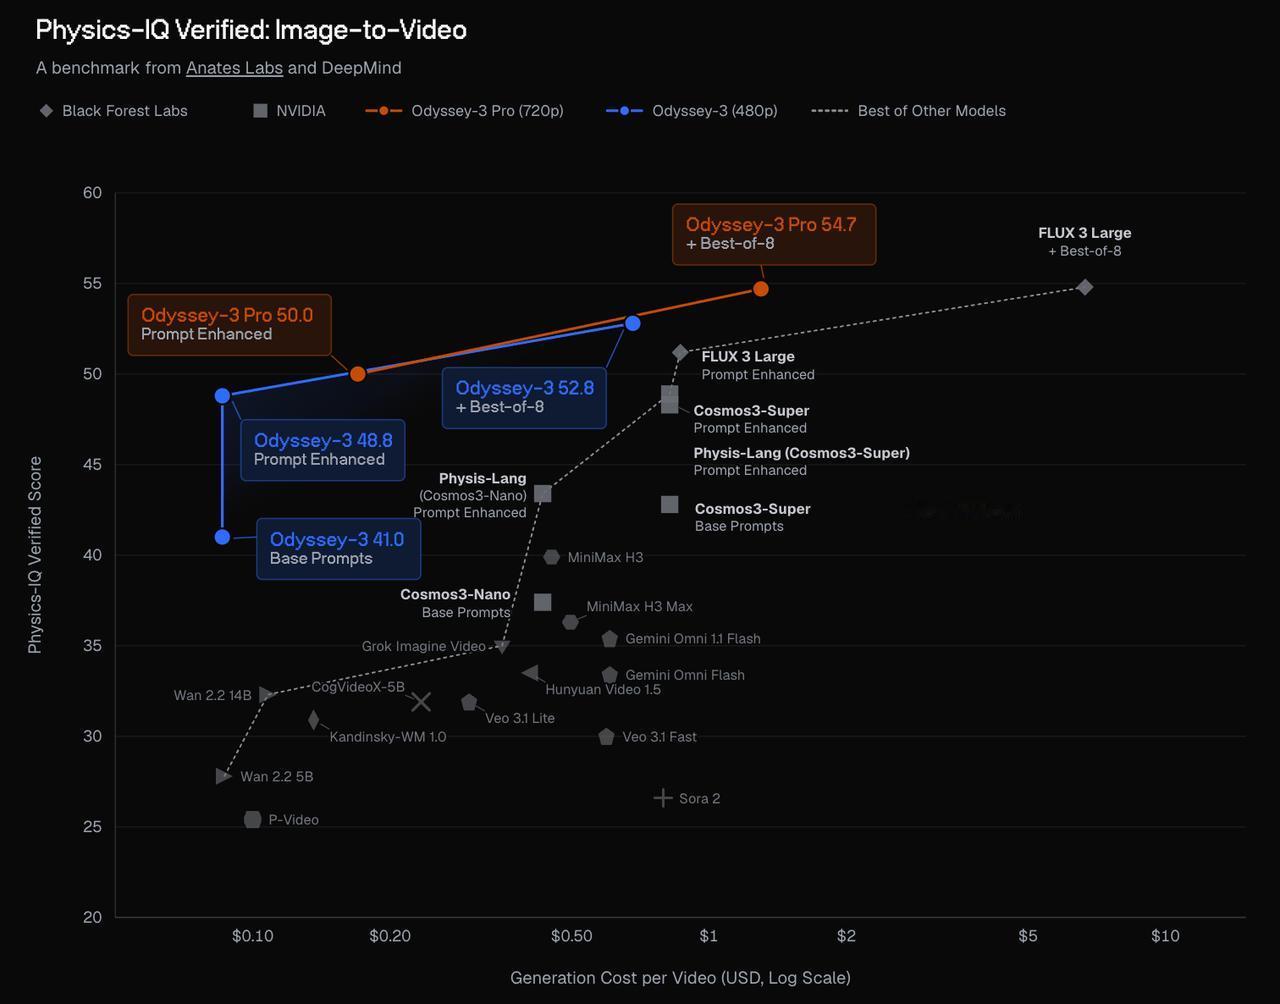
跑分喊得响:Odyssey-3 Pro 在 Physics-IQ Verified 的视频续写上拿到 66.1,官方称为"已报告的最高分"。但这得配第二个数看:66.1 是单轮生成八个候选挑一个的结果,四轮不挑的平均是 63.37。
该基准要算"纪录"得跑四轮并报标准差,66.1 不满足。这个区别 Odyssey 自己在脚注里写了。
WorldMark 那边,按官方算法(用基准自带描述语、取 13 项指标均值),Odyssey-3 在第一人称风格化、第三人称真实、第三人称风格化三类里排第一(77.2、79.0、76.3);它分数最高的第一人称真实类只排第三,80.6,前面是 Lyra 2.0 和 AlayaWorld。
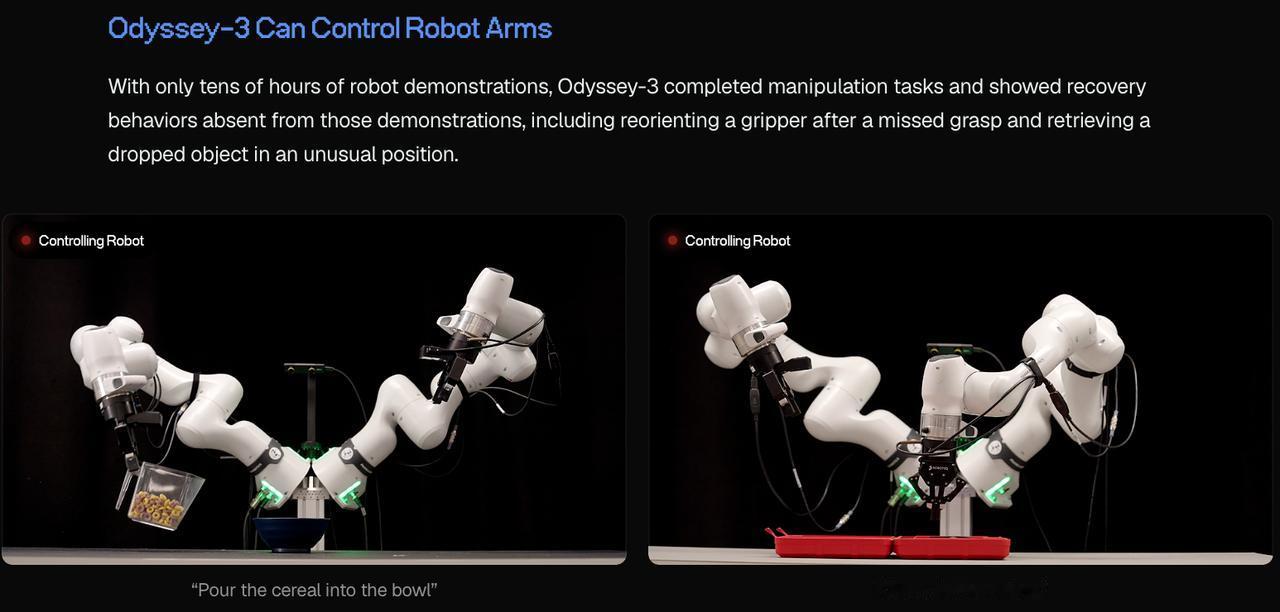
适配部分更值得看。同一套世界模型配专门的控制器:机械臂只用几十小时演示数据,还出现了演示里没有的恢复动作,抓失败后重新调整夹爪;
人形这块,瑞士 Flexion 用它做全身控制策略,官方说在光照变化下超过了所测的 VLA 基线;自动驾驶那边骨干冻结,只用约 20 小时印度真实道路数据就训出闭环驾驶策略。
限制也说清楚:权重没开放、没有标价、没有正式上线日期;想拿 API 的开发者,需联系官方。这版能玩、能看到,还谈不上能拿来生产。
分量在哪?世界模型一直关在大实验室里,外人只能看剪好的视频。
现在谁都能进去走两步,物理会不会漂、物体记不记得住、世界会不会自己变样,这些毛病在公开测试里藏不住。