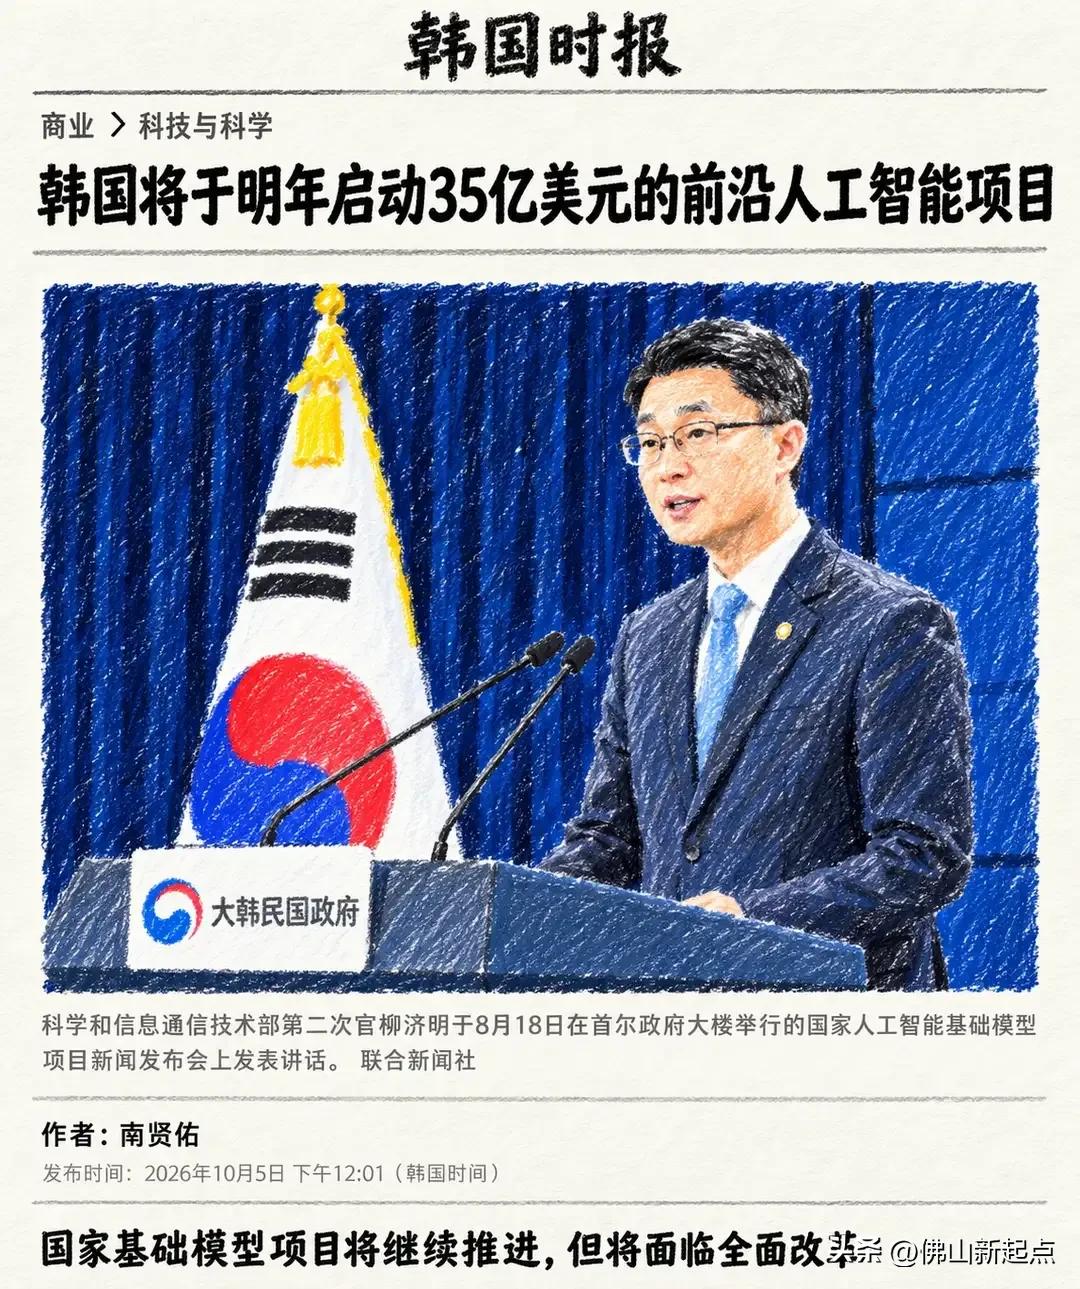
韩国豪掷4.7万亿韩元杀入前沿AI!手握英伟达顶级GPU+HBM王牌,目标对标中国顶尖开源大模型
韩国这次押上了半导体家底,发起一场国家级AI豪赌。
据韩媒最新消息,韩国科技情通部(MSIT)公布全新前沿AI(Frontier AI)项目,计划明年投入4.7万亿韩元(约35亿美元),目标打造比肩全球顶尖水平的本土大模型。项目规划采购1万张英伟达下一代Vera Rubin架构GPU,叠加生态内2.9万张B200等效算力,合计集齐3.9万张高端GPU。
韩国科技情通部第二次官柳济明在发布会上表态十分务实:现阶段想要追上美国顶尖AI并不现实,本次项目清晰的目标——达到中国头部开源大模型的水准。
为什么韩国要集中全部资源,瞄准中国开源模型发起追赶?背后是一场主权AI危机感。
此前韩国自认是美国重要半导体盟友,可当美国收紧高端大模型出口管控,Anthropic等海外AI服务权限波动,韩国才意识到:单纯依赖海外大模型,相当于租别人的房子,一旦规则变动,金融、医疗、国防等关键领域的AI应用随时会被卡住脖子。没有自研底座大模型,就没有AI主权。
韩国本土之前的Dokpamo国家大模型项目效果有限,Naver的HyperCLOVA X虽然在韩语场景表现不错,但对比DeepSeek、通义千问Qwen等国内开源模型,综合能力存在差距。于是韩国政府调整路线,拆分产业落地与前沿研发两条主线,拿出4.7万亿韩元重磅资金。
很多人只看到韩国能买到顶级GPU,却忽略它手里另一张王牌:HBM高带宽内存。
大模型训练最大瓶颈并非单纯算力,而是“显存墙”。可以简单理解:GPU是万匹马力的引擎,海量训练数据需要高速管道输送,如果内存带宽不足,强大算力只能空转,等待数据。HBM就是这条高速输送管道。全球HBM产能基本由三星、SK海力士两家韩企掌控,就连英伟达黄仁勋,也要亲自赴首尔协商HBM4产能分配。
这就形成独特格局:国内高端GPU采购受限,我们只能依靠昇腾芯片、存量算力,靠算法创新、工程优化突围;而韩国,一边可以拿到英伟达新一代高端GPU配额,一边手握全球HBM核心产能,硬件底座优势拉满。
韩国的打法是典型的“氪金路线”:既然短期内数据积累、算法工程沉淀不足,那就用顶级算力+HBM高带宽存力,靠硬件饱和投入,抹平算法层面差距。
回看国内AI发展路径,在高端芯片禁售的环境下,国内开源团队走出了另一条路。依靠MoE混合专家架构、FP8/INT4极致量化、分布式通信优化、高质量数据清洗等技术创新,基于昇腾集群和存量算力,把开源模型性能推向全球第一梯队,推理成本优势突出。相当于在硬件受限条件下,靠精妙电路设计,用干电池跑出高铁级性能。
回顾韩国产业发展史,向来擅长举国押注单点赛道:80年代倾全家之力杀入DRAM内存,之后LCD面板、动力电池、汽车产业,每一次都是豪赌。赌赢就能跻身全球头部;一旦失败,代价同样沉重。
韩国经济高度依赖财阀与半导体产业。如果只卖HBM芯片,韩国本质只是硅谷AI巨头的硬件供应商,产业链大部分利润被美国企业拿走。想要在AI时代掌握话语权,就必须拥有自主大模型,摆脱硬件代工的定位。
但大模型绝非GPU+HBM简单叠加,韩国短板同样突出:
第一是语料生态,韩语全球可用高质量语料规模很小,想要训练具备全球泛化能力的前沿模型,高度依赖英语等外文数据,这是中美积累多年的护城河;
第二是人才生态,大规模前沿大模型训练,需要海量顶尖算法、分布式工程人才,人才集群不是砸钱买芯片就能短期补齐。
全球AI战局已经分化成三条路线:美国站在最顶端,依靠资金、人才构筑壁垒;中国在算力封锁之下,依托工程能力与开源生态突围;韩国手握顶级GPU与HBM供给,重金入场,目标对标国内开源大模型。
一边是不受限制的顶级硬件资源,一边是封锁环境倒逼出来的极致工程能力。这场算力与存力、算法与生态的较量,刚刚拉开序幕。这上万张Vera Rubin芯片,究竟能否帮助韩国实现目标,还需要时间验证。