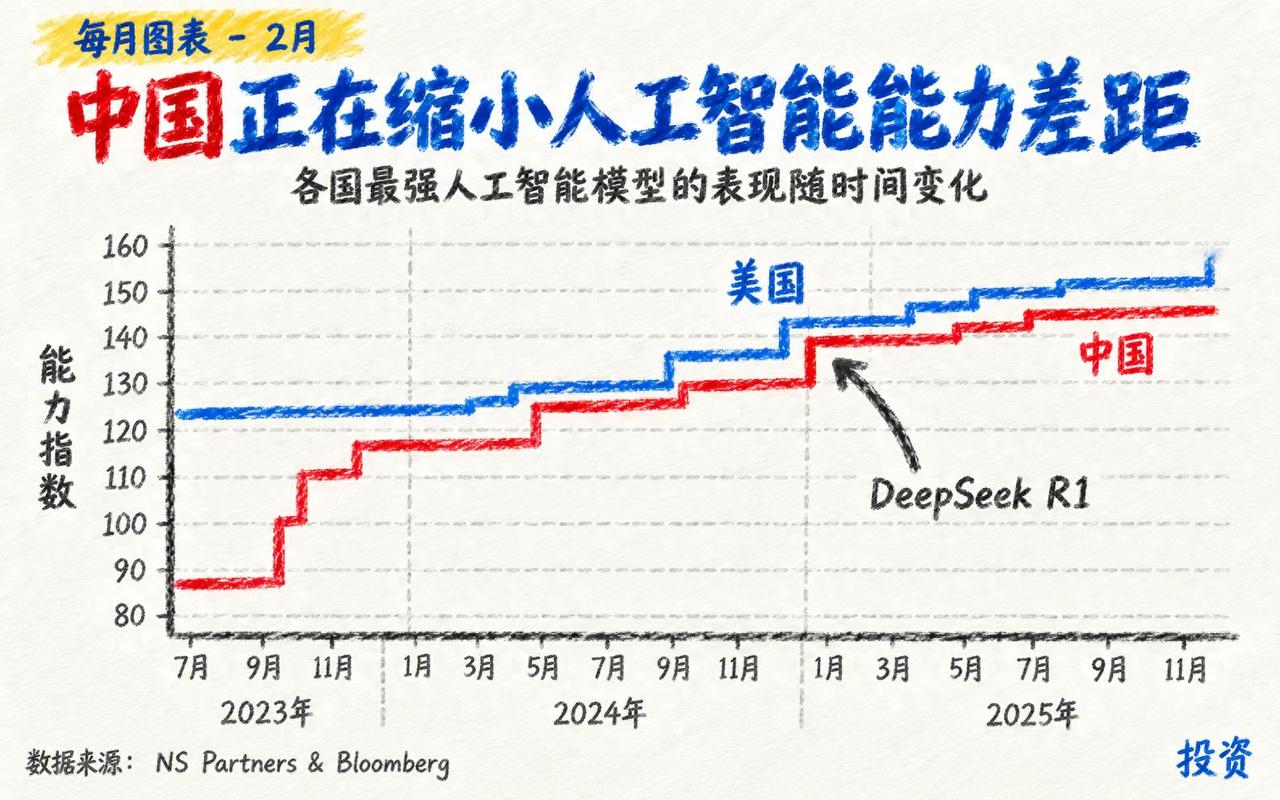
彭博最新报告,DeepSeek V4.1 Flash 发力之后,在 LiveBench 基准测试上,美国顶尖 AI 的领先优势被追到只剩 3%。年初差距还有 15%,短短几个月大幅缩小,创下新低,美国的 AI 技术壁垒,已经没有以前那么稳固了。
这个数据放在当下整个科技圈里看,震撼力确实相当大。今年 9 月公布的 LiveBench 测试榜单上面,前几名的竞争可以说到了白热化的地步。
排名第一的 Anthropic 拿到了 83.4 分,而 DeepSeek 刷出了 81.1 分。两者之间算下来也就只差了 2.3 分。
回看今年的追踪轨迹,2026 年年初双方综合跑分差距约 15%,5 月收窄至 9%,9 月 DeepSeek V4.1 Flash 迭代后,相对领先差距收窄至约 3%。
一年时间不到,测试比分硬生生被抹平了大半,这种追赶速度放在全球科技史上都很少见。
硅谷那边过去搞人工智能,主要靠的是财大手笔。那几家头部企业算账的方式非常简单,动不动就计划投上千亿美元建大型数据中心,源源不断买入最新的显卡,甚至为了解决电力供应问题,跑去跟核电站谈合作。
在他们看来,性能不够就继续往上加硬件。可是当中国团队把分差压到 3% 的时候,这种靠堆算力建立起来的高墙就显得有些笨重了。
海量资金砸下去换来的细微领先,在实际应用场景里的性价比正在变得越来越低。商业市场上很少有企业会为了这 3% 的跑分微弱优势,去承受数倍的硬件部署成本。
硬件受到限制的困境反而逼着研发团队走了一条不一样的路。
以前大家习惯了买来显卡直接套用现成代码,硬件性能其实有相当一部分被白白浪费掉了。
这次 DeepSeek 通过混合专家架构,把原本需要全员出动的计算任务,改成了按需调动的精细化分工。
用户提一个问题,模型只激活极少数对应的模块去处理,算力利用率一下子提升了好几倍。
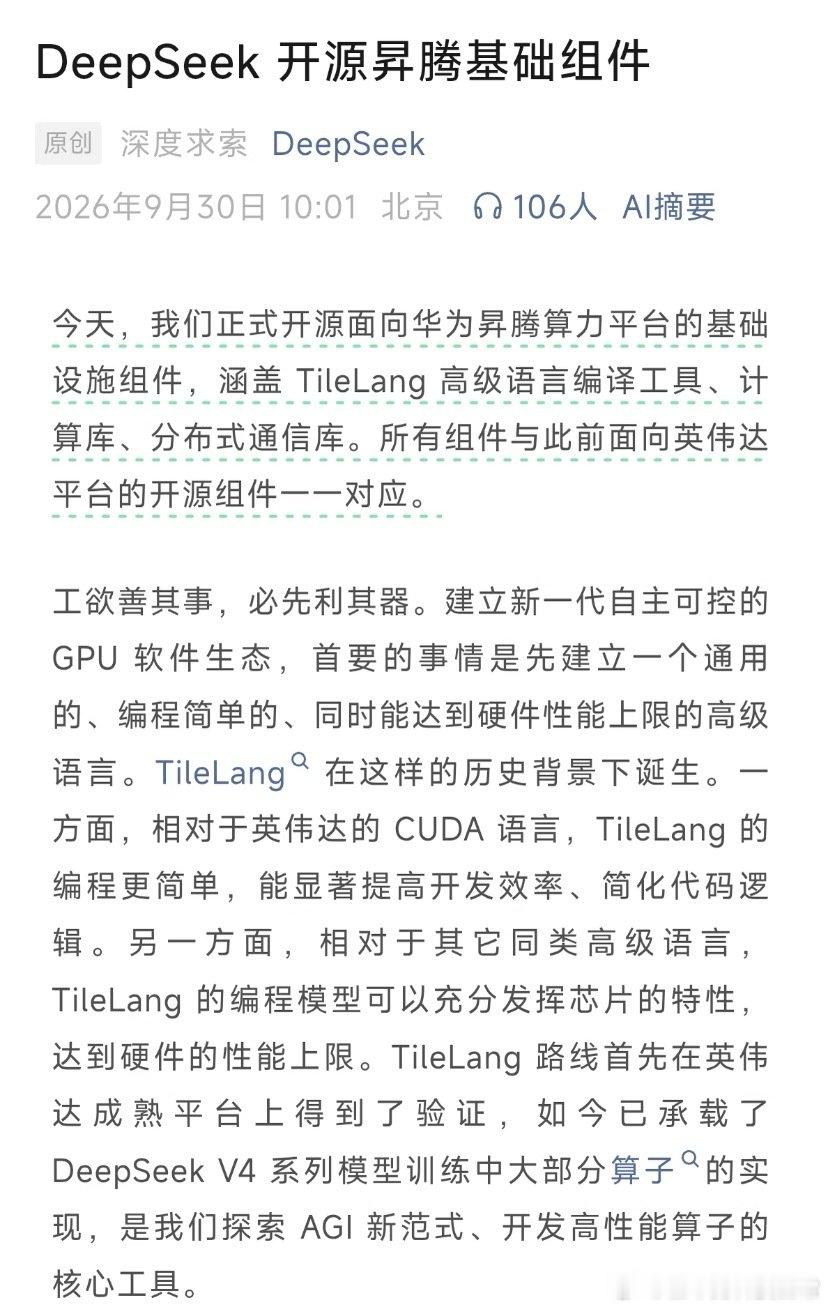
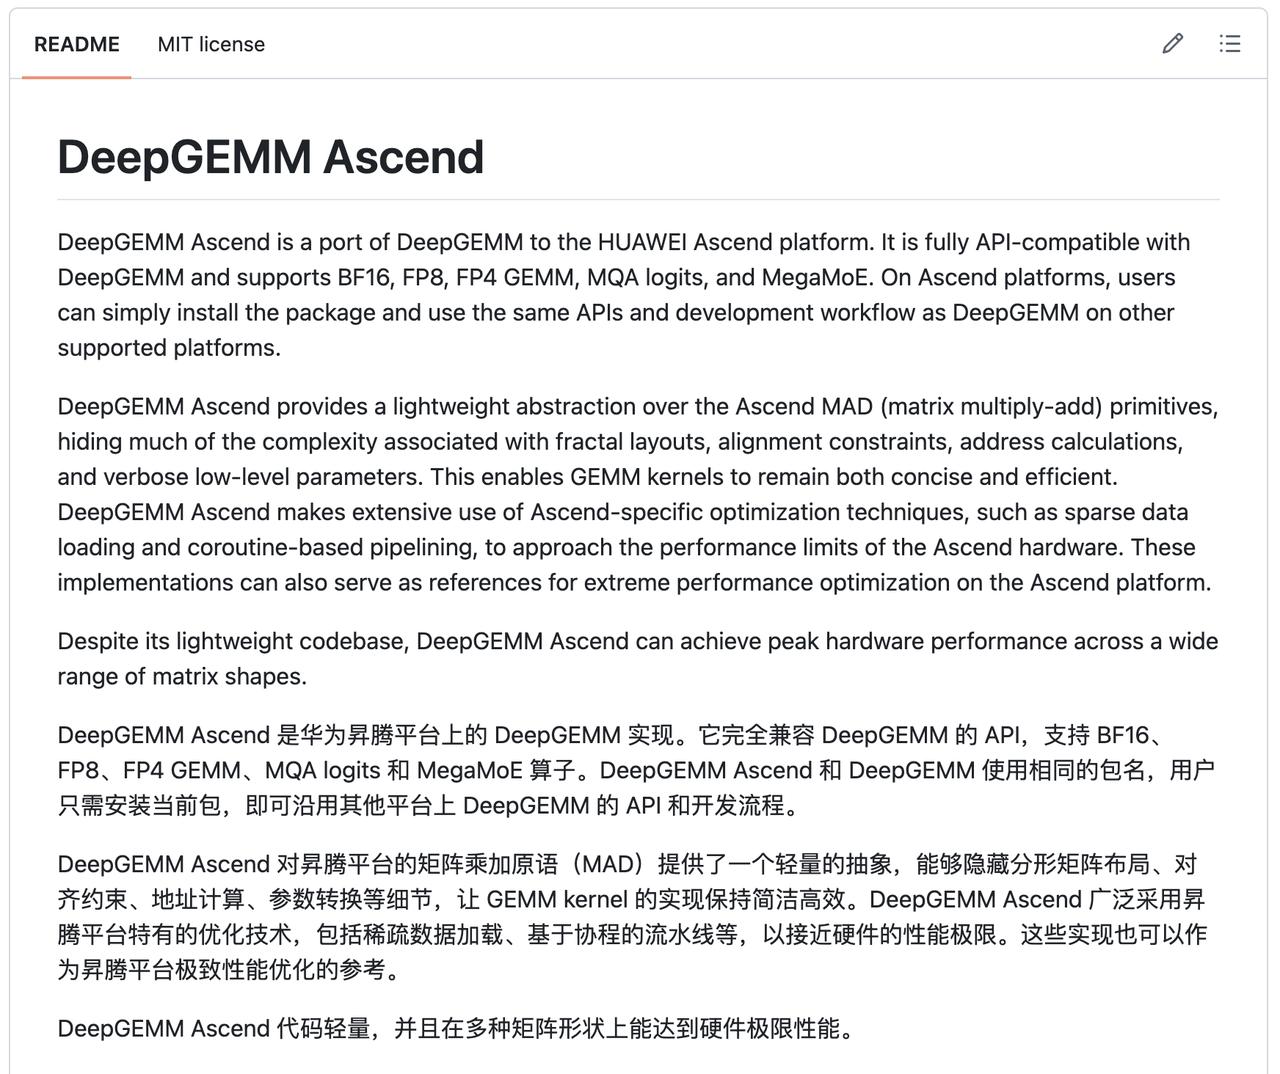
更重要的是他们深入底层,针对华为昇腾等国产芯片完成深度适配、算子优化、推理调度重构,实现软硬件深度协同。
硬件底子虽然有差距,但把软件效率发挥到极致,跑出来的实际效果照样能跟顶尖水平平起平坐。
华盛顿前几年频频出台出口管制,原本的算盘是通过芯片断供把竞争对手卡在低端领域。可实际演变出来的结局刚好相反。
当外部的现成渠道被彻底掐断,国内产业链对西方硬件的依赖心理也被一扫而空。
过去大家可能觉得跟着现成的技术路线走最省事,现在大家心无旁骛地搞自主适配和算法创新,反而在国产芯片上练出了一套特有的软硬件协同能力。
这相当于在硬件资源有限的客观条件下,砸出了一套高效率的自主生态。彭博在分析报告里也提出了类似的担忧,如果单纯依靠管制无法阻止追赶,硅谷在全球保持的技术优势还能维系多久。
当然看到成绩的同时,行业眼光也需要放得更长远一些。当前全球顶级大模型梯队中,国产头部模型已占据多个核心席位,这说明第一梯队的席位争夺依然非常激烈。
从 15% 追到 3% 展现了极强的研发爆发力,但真正的长期考验还在后面。大模型的竞争不单单是榜单跑分,还包括接下来在各行各业的落地效率、商业盈利能力以及持续迭代的速度。
对方不可能原地踏步,后续的新产品推出后分差随时可能产生波动。
但不可否认的是,硬件封锁无法完全锁死技术迭代的上限,依托架构创新、软硬件极致优化的追赶路径已经被验证可行,后续的顶峰较量只会越来越精彩。晒图笔记大赛
参考来源:新浪财经,《彭博:中美大模型性能差距缩至 3%》,2026-10-06