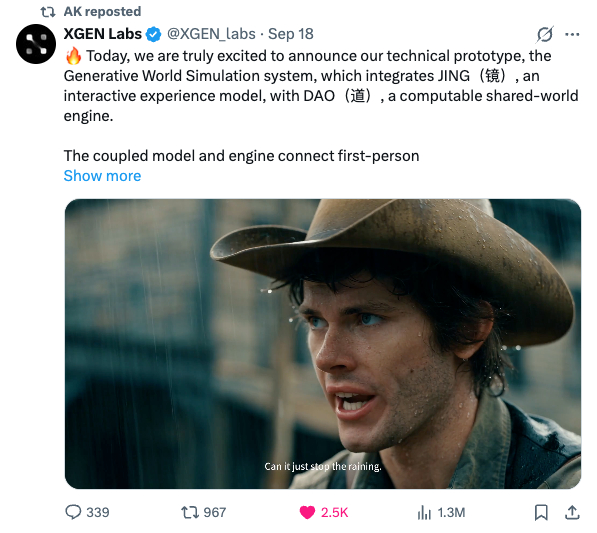
这两天,我刷到了一支很火的Demo,来自一家叫XGEN的世界模型团队,播放量已经突破140万了!
XGEN的这次发布,还被海外AI圈很有影响力的AK转发了。
片子讲了一个有点像许愿游戏的故事。在一个下雨的西部小镇,送货少年只要说出自己的愿望,眼前的世界就会立刻发生变化。
他说,希望雨停下来,雨滴就真的悬在了空中;他说,想要一匹更快的马,驴瞬间变成骏马。
屏幕上一直显示着虚拟摇杆和Live control语音条,少年继续用语音改变周围的世界,他许下的愿望越来越大,连一副巨大的鲸鱼架都出现在了小镇上空。
但有意思的是结尾部分。几个月后,小镇已经被这些愿望改变。出现在天空中的鲸鱼架,没有随着镜头结束而消失,而是被镇民改成了一座舞厅。
玩家做过的事,不只临时改变了画面,还被这个世界记了下来。
很多AI视频都能把愿望画出来,但XGEN想验证的是,如果AI能够记住每一次行动留下的后果,视频会不会从一段看完就结束的内容,变成一个持续运行的世界呢?
1视频模型和世界模型,正在演化成两条不同的路线。
过去两年,视频模型主要解决的是生产问题。用户写提示词,模型生成画面,最后交付的是一个可以播放的文件。
但世界模型关心的不是怎么把视频做得更快,而是画面能不能变成一个可以进入的环境。它得持续记住角色、物体和已经发生的事,既保留视频的表现力,同时允许用户在过程中改变事情。
更重要的是,这些改变不能只做成即时特效,还要进入后续的运行逻辑。
虽然传统游戏也有很多地图、任务和反馈,但都是开发团队提前设计好的。生成式世界想往前走一步,让更多变化在运行过程中实时发生。
XGEN想试的是,让AI实时呈现体验,同时让世界的状态继续运转。在它的Demo里,语音和摇杆会直接影响环境,而且这些影响都会进入后续剧情里。
如果这条路能走通,创作者制作的可能不再是一段剧情,而是一个能容纳剧情的空间。用户进入以后,故事才真正开始。
2当然,想法是一回事,技术上能不能做到又是另一回事。
XGEN是如何保证画面能自洽的呢?很多生成模型擅长画出合理的下一帧,却不擅长长期维护事实。镜头转开以后,物体可能换位置,角色状态也可能被重置。
我去看了一下XGEN公开的技术路线,它把系统拆成了JING和DAO。简单来说,JING主要管你眼前经历什么,DAO管你看不见的时候,这个世界还在发生什么。
你操作角色、说出愿望,JING负责把这些变化呈现出来。镜头转开以后,DAO会继续维护人物、物体和世界规则,让此前发生的事情接着往下发展。
所以它要解决的不只是把前面的内容存下来,而是让玩家造成的变化,变成这个世界接下来运行的一部分。你走过留下痕迹,痕迹又会影响下一刻。
3Demo最后,镜头从小镇拉回现实。
有人戴着VR头显,有人拿着平板,最后连一个戴牛仔帽的机器人,也坐在屏幕前看着同一个世界。
这不是随手加进去的彩蛋,而是透露了XGEN想去的方向。XGEN把这种关系叫作双向门,一个入口,两个方向。
一个方向朝着人。以前我们和视频、和虚拟世界之间的关系基本只有观看,最多算是围观。
但XGEN 想做的,是让人也可以进入AI生成的世界,在里面探索、做决定,跟其他人、跟 AI 一起经历某段情节。
另一个方向朝着 AI,这个视角可能是很多人一开始没想到的。更长期来看,是希望 AI 也能先在这样的环境里行动、试错,再把学到的东西用到现实任务里。
现实里的机器人经不起无限次试错,危险场景也不适合反复重演。一个有状态的生成世界,可以先让智能体在里面学习,并面对自己造成的后果。
4世界模型,正在变成越来越多 AI 公司关注的方向,Google、NVIDIA、World Labs、字节都在往这里走。
XGEN 这次让我比较在意的,倒不是又多了一个世界模型团队,而是它把一个很具体的问题摆到了眼前:以前 AI 生成的是一段看完就结束的视频,未来有没有可能生成一个你退出以后,还会继续发生事情的地方?
当然,现在还不能把 XGEN 的这个原型当成一款成熟的消费产品。它目前仍然是研究预览,离一个稳定、人人都能使用的生成世界还有距离。
最后它会长成游戏、内容平台,还是 AI 的训练环境,现在都很难下结论。但如果这种方向继续往前走,视频可能真的不会再只有开头和结尾。
当我们关掉屏幕后,里面的故事还在继续。