PINN避坑别只看loss,要看空间误差分布
学弟学妹,最近好多人找我聊PINN,踩的坑几乎一模一样,今天掰开跟你们聊聊。
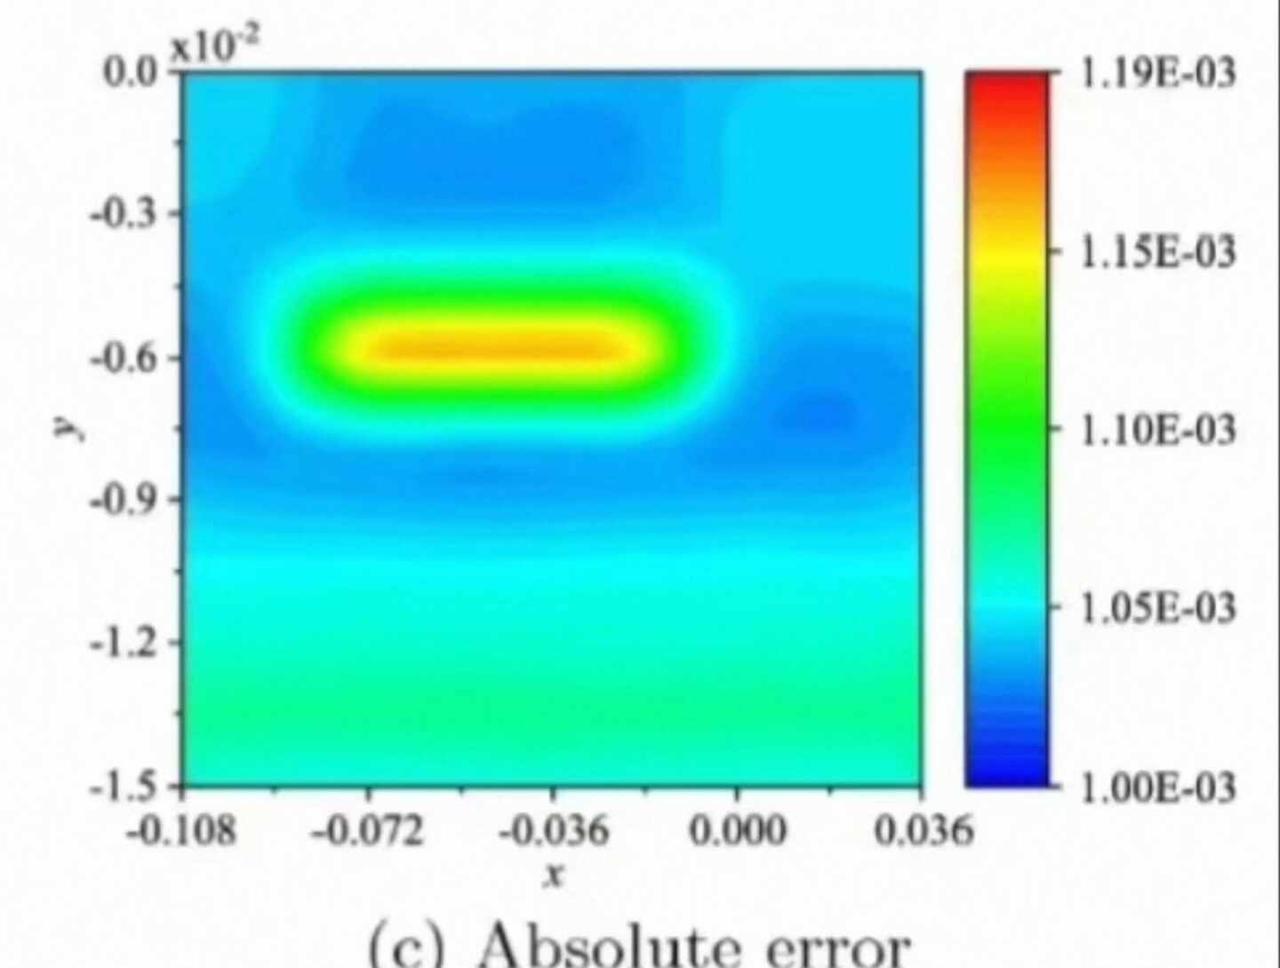
先看第一张图,是绝对误差云图。很多同学跑出来模型,误差分布完全不对,集中在一小块区域,其余地方误差看着低,但其实是假收敛。你们大概率是只盯着整体损失看,忽略了残差在求解域的空间分布。单纯把loss降到很低没用,局部区域残差爆炸,最后预测结果直接跑偏。
解决办法:不要只看损失曲线,一定要画误差云图做空间校验。在误差高的区域,自适应加密采样点,在梯度变化剧烈的位置增加配点,强制模型在高误差区域拟合物理约束,而不是让模型偷懒,只在简单区域降低损失。
第二张图,强化学习奖励曲线,DDPG、SAC、TD3三条线。很多同学在用PINN结合强化学习做物理反问题的时候,奖励震荡严重,训练很难稳定上升。很多人以为调大学习率就能解决,越调越崩。本质问题是物理约束和奖励函数没有耦合,模型只顾最大化奖励,违背控制方程。
解决办法:把物理残差作为正则项嵌入奖励函数,每次更新策略网络的时候,同步约束物理方程。分开评估两个指标:奖励值和物理残差,不能只看奖励高低。还要做梯度裁剪,防止策略更新的时候,物理残差梯度爆炸,训练曲线来回抖动。
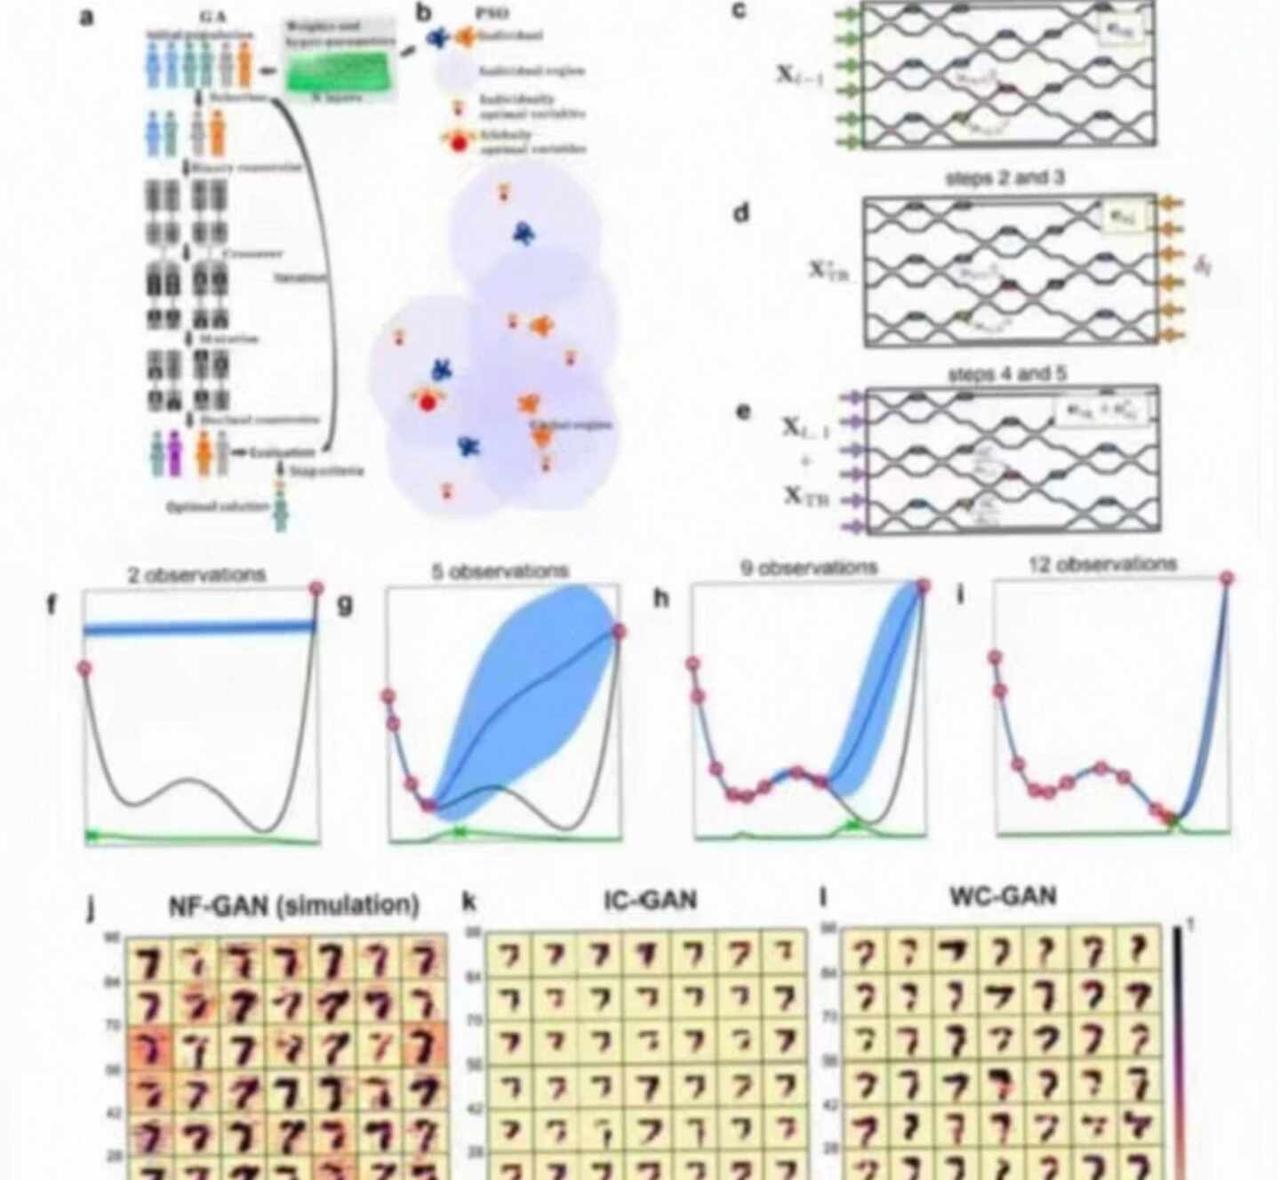
第三张这组图,是不同观测数据下的拟合效果,还有GAN类对比。不少学弟学妹做PINN反问题,观测数据太少,少量观测点根本约束不住解空间,模型会跑出无数个满足观测点但违背物理的虚假解,也就是解空间多解性问题。数据少的时候,普通PINN很容易直接跑偏。
解决办法:用生成式框架做物理先验增强,在少量观测的条件下,引入物理流形约束,压缩可行解的范围。随着观测点数量逐步增加,逐步收紧约束,把候选解空间慢慢缩小,让解收敛到真实物理解。对比不同生成框架,筛选能贴合物理方程的模型,抑制不符合物理规律的伪解。
做PINN最怕埋头调参,不看空间误差、不耦合物理约束、不处理少观测下的多解问题,最后跑出来的结果看着好看,一验证就翻车。
不管是正问题求解、参数反演、耦合强化学习的物理控制、少量观测数据下的物理场重建,还有结合生成模型做物理先验,只要是PINN相关的方向,全网能落地的方案我都吃透了。
遇到卡在训练不收敛、残差降不下去、少样本求解、多物理场耦合这些难题,直接来聊。
PINN 物理神经网络 深度学习 计算物理 科研干货 神经网络