通义千问正式发布新一代原生全模态模型 Qwen3.8-Omni-Flash,同步推出实时交互版本及两款开源工具套件,核心推动全模态能力从 “内容理解” 向 “端到端任务交付” 升级。
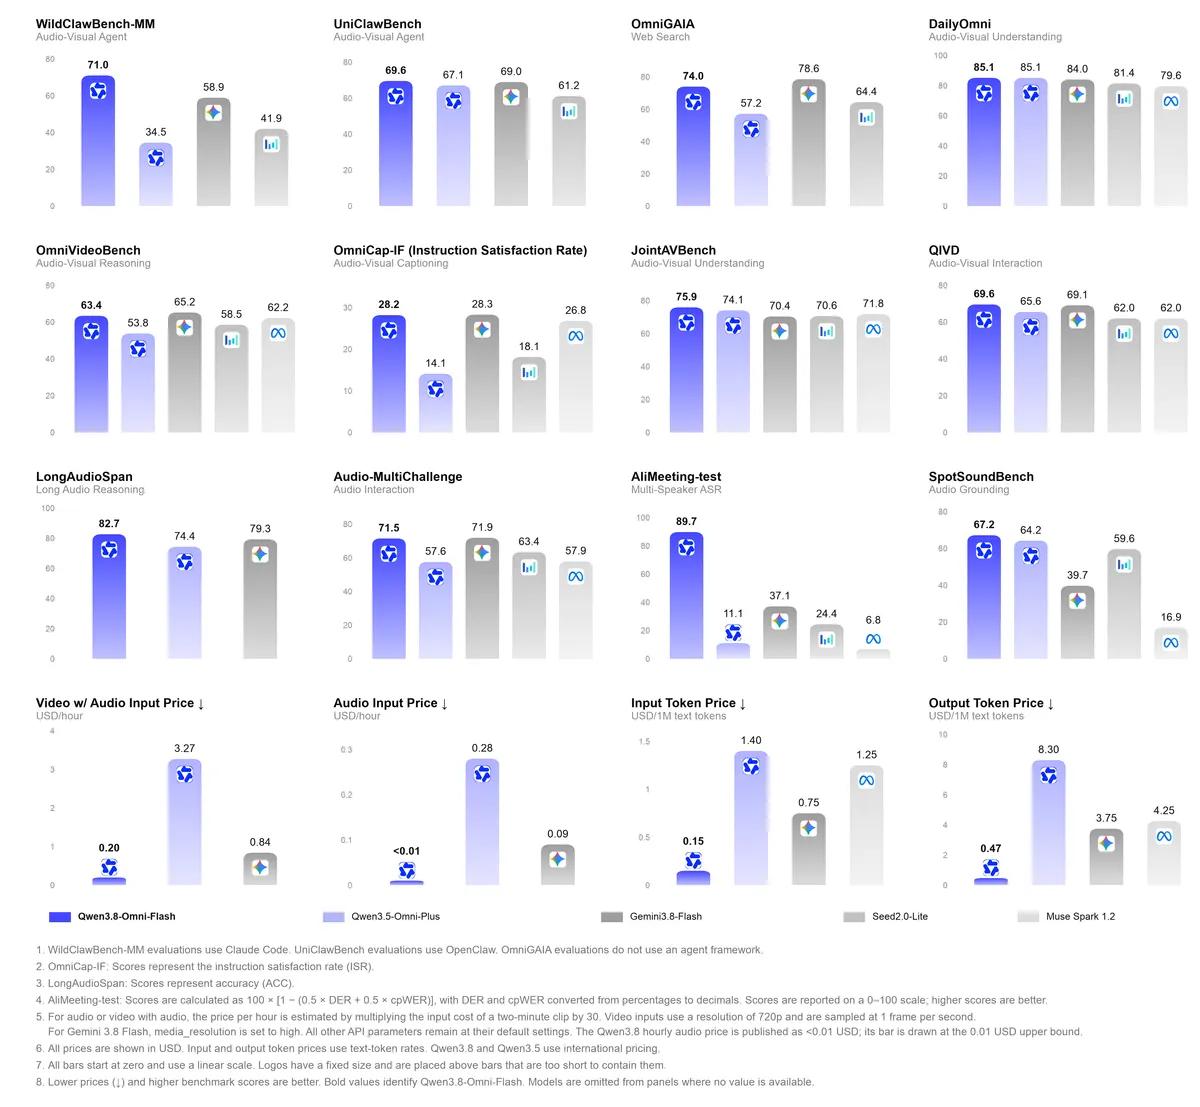
模型原生支持文本、图像、音频、视频四类输入,搭载 1M token 上下文窗口。29 项综合评测显示,平均分较上代 Qwen3.5-Omni-Plus 提升超 25%;成本端优化显著,音频输入每小时 API 价格降幅超 98%,音视频联合输入价格下降超 93%。音视频智能体专项基准中,WildClawBench-MM、AgenticVBench 分别提升 36.5、22.3 分,整体音频表现超越 Gemini 3.8 Flash,音视频综合能力跻身行业第一梯队。
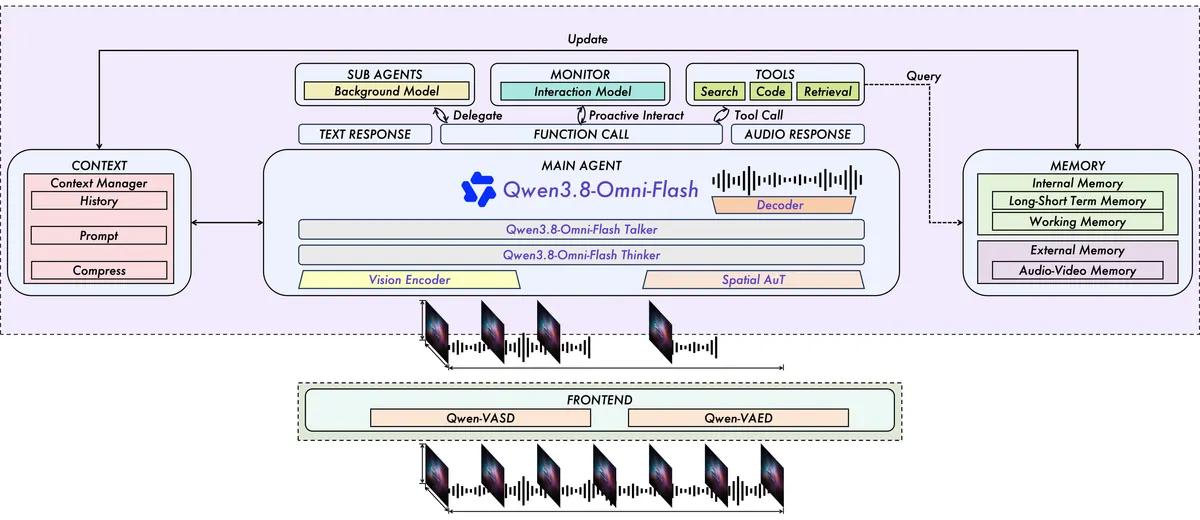
核心突破在于智能体式音视频理解机制。传统方案需全量读取音视频内容,算力消耗高。Qwen3.8-Omni-Flash 可基于用户问题自主筛选关键片段,通过由粗到细的多轮证据检索定位信息,无需逐帧处理。测试显示,该模式下 token 消耗降低 45.7%,同时识别准确率不降反升。
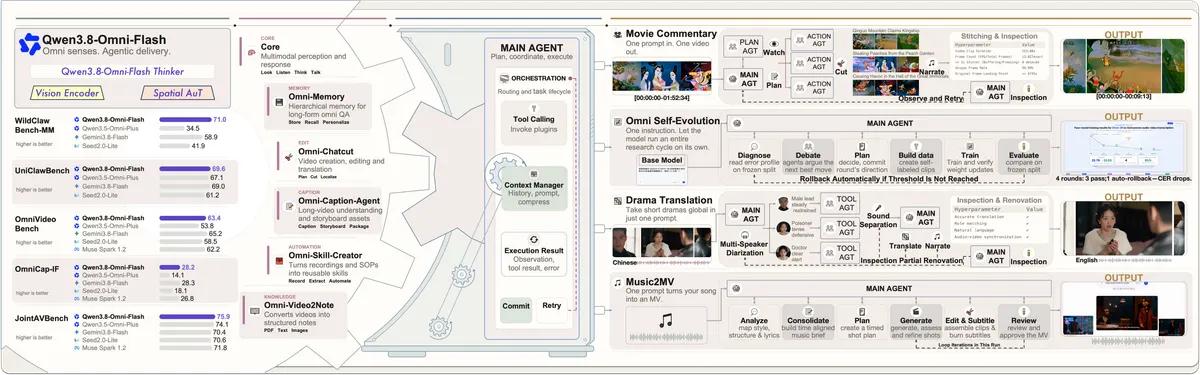
落地场景覆盖音视频生产全链路:音乐 MV 创作可解析歌曲结构并输出分镜方案;短剧翻译可一站式完成说话人识别、字幕翻译与配音混音;长电影解说可自动提取剧情、生成脚本并调配音轨;会议场景可联合音视频区分发言人,输出纪要与待办事项,还可联动工具派发任务。此外模型还能自主迭代小模型,或从视频中萃取结构化知识与标准化 SOP。
实时版本主打低延迟连续音视频交互,支持 WebSocket、WebRTC 接入,具备空间音频定位能力,可结合视觉完成空间导航,支持动态注入业务知识与角色设定,适配实时客服、口语教学等场景。
配套同步开源 Qwen-MM-Plugins 插件套件与 Qwen-Live Harness 运行框架,兼容主流智能体框架;API 兼容 OpenAI 协议,支持三档推理强度调节,方便开发者按需权衡成本与效果。
整体来看,本次发布将音视频从感知输入升级为智能体执行任务的原生媒介,成本大幅下降加速工程化落地,但复杂长叙事内容的一致性控制仍待持续打磨。
Qwen大模型音视频智能体Agent前沿在线